
こんにちは、AI Labの浅野晟です。
前回の記事では、要件定義書をもとにAIでOpenTofu用の変数ファイルを生成し、LocalStack上でIaCの自動化を検証するプロトタイプをご紹介しました。
今回はその続きとして、より実案件に近い詳細設計書を入力にしながら、AIでdynamic_var.tfvarsを生成し、その結果をLocalStackとAWSの両方で検証しやすいOpenTofu構成へ発展させたプロジェクトについてご紹介します。
前回は「AIで変数ファイルを作れるか」という検証色の強い内容でしたが、今回はそこから一歩進めて、
「詳細設計書の情報を、実際にOpenTofuへ流し込める形にどう整えるか」
を主題にしています。
目次
今回の目的
今回のプロジェクトで目指したのは、以下の3点です。
- 詳細設計書をもとに、AIが案件ごとの
dynamic_var.tfvarsを自動生成できるようにする - 生成した変数ファイルをOpenTofuにそのまま流し込み、LocalStackとAWSの両方で検証しやすい状態にする
- VPC、Subnet、Security Group、EC2などをリソース単位で確認できる構成にし、段階的に検証できるようにする
つまり今回は、
「AIによる変数生成」と
「OpenTofuによる検証基盤」
の両方を、詳細設計書ベースでつなぐことがゴールでした。
前回からの課題
前回のプロトタイプでは、要件定義書からAIで変数ファイルを生成し、LocalStackへ流し込む流れ自体は確認できていました。
一方で、実案件に寄せていくと次の課題が見えてきました。
- 要件定義書だけでは必要な情報が揃わない
- AIが設計書にない値を推測してしまう
- テンプレートの粒度が粗いと、OpenTofuでそのまま使えないHCLが出力される
- 生成後にどのリソースで問題が起きているか切り分けにくい
- LocalStackでの高速検証とAWSでの確認を、同じ構成で回したい
そのため今回は、単にAIでファイルを出力するだけではなく、
- 入力データの取り出し方
- OpenTofu側のmodule構成
- 段階検証の進め方
まで含めて見直す必要がありました。
全体アーキテクチャ
今回の全体像は、以下の流れです。
- 詳細設計書の複数シートをCSVとしてまとめて取得する
- PythonスクリプトでCSVを読み込み、AIへ渡す入力を組み立てる
dynamic_var.tfvars.tmplをもとに、AIがdynamic_var.tfvarsを生成する- OpenTofuがその変数ファイルを読み込み、LocalStackまたはAWSに対してplan/applyを実行する
- 必要に応じて、root moduleから特定moduleだけを
-target=module.<name>で部分検証する
この構成にした背景には、 インフラの定義そのものは案件をまたいで共通化できるという前提があります。
案件ごとに変わるのはあくまで差分であり、 その差分を動的変数として切り出し、変わらない静的値と分けて管理することが今回の設計の軸です。
これにより、AIの出力をそのまま信用するのではなく、 設計書と生成結果の差分だけをレビューすればよい状態を目指しています。
Detail-IaC-Project/
├── Dockerfile
├── docker-compose.yml
├── Makefile
└── Workspace/
    ├── data/          # 詳細設計書由来のCSV入力
    ├── scripts/       # CSV読込・AI呼び出し
    └── AWS/
        ├── main.tf
        ├── variables.tf
        ├── provider.tf
        ├── static_var.auto.tfvars
        ├── envs/
        │   └── dynamic_var.tfvars
        ├── templates/
        │   └── dynamic_var.tfvars.tmpl
        ├── modules/
            ├── vpc/
            ├── subnet/
            ├── route_table/
            ├── security/
            ├── ec2/
            ├── nacl/
            ├── igw/
            └── eip/
data/が入力、scripts/がAI連携、AWS/がOpenTofuの実行基盤 という役割分担です。
詳細設計書をどう入力データにしたか
実案件では、必要な情報は1枚の表にまとまっているわけではなく、構築確認シート、VPC、FW(SG)など複数のシートに分かれていました。そこで、まずGoogle Apps Scriptで複数シートをまとめて1つのCSVとして出力できるようにしました。
シートごとの中身はそのままCSV化しつつ、間に### Sheet: <シート名>という区切りを入れることで、AIがどの情報をどのシートから読んでいるか追いやすくしています。
ここで利用したGASは、スプレッドシートのメニューから対象シート名を指定し、複数シートをそのまま1つのCSVへまとめてダウンロードするシンプルな構成です。重要なのは、CSVの値を加工しすぎず、スプレッドシートの情報をなるべく素直に持ってくることでした。
ここでは、実際に今回使った詳細設計書のマスク版に近い形で、画像、CSV、tfvarsの対応をそのまま並べます。(実際とは異なるイメージです)
詳細設計書の例
- スプレッドシート
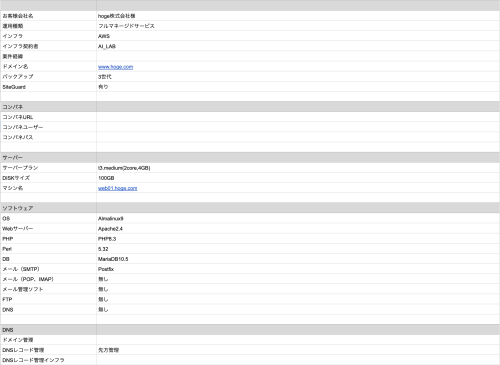
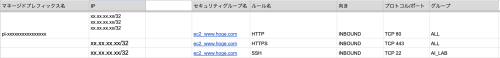
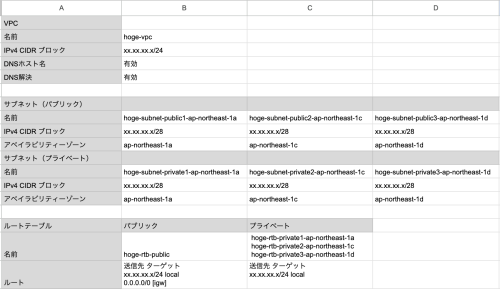
- csvファイル
### Sheet: 構築確認シート
,
お客様会社名,hoge株式会社様
運用種類,フルマネージドサービス
インフラ,AWS
インフラ契約者,AI_LAB
案件経緯,
ドメイン名,www.hoge.com
バックアップ,3世代
SiteGuard,有り
,
コンパネ,
コンパネURL,
コンパネユーザー,
コンパネパス,
,
サーバー,
サーバープラン,"t3.medium(2core,4GB)"
DISKサイズ,100GB
マシン名,web01.hoge.com
,
ソフトウェア,
OS,Almalinux9
Webサーバー,Apache2.4
PHP,PHP8.3
Perl,5.32
DB,MariaDB10.5
メール(SMTP),Postfix
メール(POP、IMAP),無し
メール管理ソフト,無し
FTP,無し
DNS,無し
,
DNS,
ドメイン管理,
DNSレコード管理,先方管理
DNSレコード管理インフラ,

### Sheet: FW(SG)
マネージドプレフィックス名,IP,,セキュリティグループ名,ルール名,向き,プロトコル/ポート,グループ
pl-xxxxxxxxxxxxxxxx,"xx.xx.xx.xx/32
xx.xx.xx.xx/32
xx.xx.xx.xx/32
xx.xx.xx.xx/32
xx.xx.xx.xx/32",,ec2_www.hoge.com,HTTP,INBOUND,TCP 80,ALL
,xx.xx.xx.xx/32,,ec2_www.hoge.com,HTTPS,INBOUND,TCP 443,ALL
,xx.xx.xx.xx/32,,ec2_www.hoge.com,SSH,INBOUND,TCP 22,AI_LAB

### Sheet: VPC
VPC,,,
名前,hoge-vpc,,
IPv4 CIDR ブロック,xx.xx.xx.x/24,,
DNSホスト名,有効,,
DNS解決,有効,,
,,,
サブネット(パブリック),,,
名前,hoge-subnet-public1-ap-northeast-1a,hoge-subnet-public2-ap-northeast-1c,hoge-subnet-public3-ap-northeast-1d
IPv4 CIDR ブロック,xx.xx.xx.x/28,xx.xx.xx.x/28,xx.xx.xx.x/28
アベイラビリティーゾーン,ap-northeast-1a,ap-northeast-1c,ap-northeast-1d
サブネット(プライベート),,,
名前,hoge-subnet-private1-ap-northeast-1a,hoge-subnet-private2-ap-northeast-1c,hoge-subnet-private3-ap-northeast-1d
IPv4 CIDR ブロック,xx.xx.xx.x/28,xx.xx.xx.x/28,xx.xx.xx.x/28
アベイラビリティーゾーン,ap-northeast-1a,ap-northeast-1c,ap-northeast-1d
,,,
ルートテーブル,パブリック,プライベート,
名前,hoge-rtb-public," hoge-rtb-private1-ap-northeast-1a
 hoge-rtb-private2-ap-northeast-1c
 hoge-rtb-private3-ap-northeast-1d",
ルート,"送信先 ターゲット
xx.xx.xx.x/24 local
0.0.0.0/0 [igw]","送信先 ターゲット
xx.xx.xx.x/24 local
といった形で、詳細設計書をcsvとしてダウンロードします。
それを元にAIに変数ファイルを生成させると以下のようになります。
- tfvarsファイル
# provider
environment         = "local"
aws_region          = "ap-northeast-1"
localstack_endpoint = "http://localstack:4566"

# vpc
vpc_name             = "hoge-vpc"
vpc_cidr             = "xx.xx.xx.x/24"
enable_dns_hostnames = true
enable_dns_support   = true

# subnet
public_subnets = [
  { name="hoge-subnet-public1-ap-northeast-1a", cidr_block="xx.xx.xx.x/28", availability_zone="ap-northeast-1a" },
  { name="hoge-subnet-public2-ap-northeast-1c", cidr_block="xx.xx.xx.x/28", availability_zone="ap-northeast-1c" },
  { name="hoge-subnet-public3-ap-northeast-1d", cidr_block="xx.xx.xx.x/28", availability_zone="ap-northeast-1d" },
]

private_subnets = [
  { name="hoge-subnet-private1-ap-northeast-1a", cidr_block="xx.xx.xx.x/28", availability_zone="ap-northeast-1a" },
  { name="hoge-subnet-private2-ap-northeast-1c", cidr_block="xx.xx.xx.x/28", availability_zone="ap-northeast-1c" },
  { name="hoge-subnet-private3-ap-northeast-1d", cidr_block="xx.xx.xx.x/28", availability_zone="ap-northeast-1d" },
]

# route_table
public_route_table_name = "hoge-rtb-public"

private_route_table_names = [
  "hoge-rtb-private1-ap-northeast-1a",
  "hoge-rtb-private2-ap-northeast-1c",
  "hoge-rtb-private3-ap-northeast-1d"
]

# Security Groups
security_groups = [
  {
    name        = "ec2_www.hoge.com"
    description = "Web Security Group"

    rules = [
      # HTTP 80 : ALL
      {
        type        = "ingress"
        protocol    = "tcp"
        from_port   = 80
        to_port     = 80
        cidr_blocks = ["0.0.0.0/0"]
        description = "HTTP inbound (ALL)"
      },

      # HTTPS 443 : ALL
      {
        type        = "ingress"
        protocol    = "tcp"
        from_port   = 443
        to_port     = 443
        cidr_blocks = ["0.0.0.0/0"]
        description = "HTTPS inbound (ALL)"
      },

      # SSH 22 : AI_LAB
      {
        type        = "ingress"
        protocol    = "tcp"
        from_port   = 22
        to_port     = 22
        cidr_blocks = [
          "xx.xx.xx.xx/32",
          "xx.xx.xx.xx/32",
          "xx.xx.xx.xx/32",
          "xx.xx.xx.xx/32",
          "xx.xx.xx.xx/32"
        ]
        description = "SSH inbound (AI_LAB)"
      },
    ]
  },
]

# EC2
ec2_name_tag            = "web01"
ec2_instance_type       = "t3.medium"
ec2_key_name            = "web01.hoge.com-xxxx"
ec2_root_volume_size_gb = 100
AIによるdynamic_var.tfvars生成の流れ
今回の中心処理は、Pythonスクリプトgenerate_dynamic_vars.pyです。
このスクリプトでは、まずWorkspace/data配下のCSVをすべて読み込みます。1ファイルの中に複数シート分がまとまっていても、今後ページ追加に対応しやすいよう、ディレクトリ内のCSVをまとめて読む形にしています。
次に、dynamic_var.tfvars.tmplをAIへの出力テンプレートとして利用します。ここで重要だったのは、AIに自由記述させるのではなく、
- 変数名
- リスト構造
- オブジェクトのキー名
- HCLの形
をテンプレートで先に固定しておくことでした。
初期段階では、テンプレートの粒度が粗かったため、
igw_name = "任意"のように日本語の説明をそのまま出力してしまう- AMI IDのような未記載項目を勝手に補完してしまう
- SubnetやSGのキー名を独自解釈してしまう
といった問題が起きました。
そこで今回は、プロンプトとテンプレートの両方を厳格化しています。
今回意識したルール
- 設計書にない値は推測せず空文字または空リストにする
- 変数はオブジェクトでラップせず、トップレベルのフラットな形で出力する
ALLやTOWNのような表記は、AWSで扱える形式に変換する- NACLやSecurity Groupのような複雑な構造は、必要なキーをテンプレートで明示する
- モジュール仕様に影響する箇所は、例外ルールとしてプロンプトに固定で与える
特に、前回と異なり変数をxxx_config = {}のようにラップしなかったのは、 .auto.tfvarsの自動読込と-var-file指定という、
Terraform/OpenTofuの標準的な変数読込順をそのまま活かしたかったためです。
旧プロジェクトでは静的値と動的値を localsでマージする構成を取っていましたが、
この方法では変数を大きなオブジェクトとして持つ必要があり、
IaC側でマージロジックを自前で管理しなければなりませんでした。
今回はその構成を見直し、各変数をフラットに独立させることで、 「どの値が固定で、どの値が案件依存か」 をファイル単位で明確に追えるようにしています。
OpenTofu側の構成見直し
今回のOpenTofu構成では、root moduleから以下のmoduleを呼び出す形に整理しました。
vpcigwsubnetroute_tablesecurityec2nacleip
この分割で特に重視したのは、再利用性よりも「段階検証のしやすさ」です。
実案件に近い構成を扱う場合、最初からすべてのリソースを一気に確認しようとすると、エラーが出たときに切り分けが難しくなります。そこで、VPC、Subnet、Route Table、Security Group、EC2といった単位で責務を分け、rootからmoduleを呼び出す構成にしました。
この構成に至るまでには試行錯誤もありました。各moduleを独立した実行ルートとして持たせる案もありましたが、その場合、SubnetからVPCを参照するような依存関係を自然に扱いにくく、変数定義やtfファイルの二重管理も発生しやすくなります。
そのため最終的には、Terraform/OpenTofu標準のmodule機能を使い、AWS直下のmain.tfをroot moduleにして、そこから各moduleを呼び出す構成へ再編しました。これにより、依存関係をroot側で解決しつつ、必要な時だけ特定moduleを部分検証できるようになりました。
また、以前のように各リソースの.tfを同一階層に並べる形だと、依存関係を含めた検証や、どの単位でテストしたいかが見えづらくなります。module化することで、
- rootから全体実行するルート
- 特定moduleだけを重点的に確認するルート
を分けやすくなりました。
ディレクトリ構成の変化を簡略化すると、イメージは以下のようになります。
変更前のイメージ
Workspace/AWS/
├── vpc.tf
├── vpc_variable.tf
├── subnet.tf
├── subnet_variable.tf
├── route_table.tf
├── route_table_variable.tf
├── igw.tf
├── igw_variable.tf
├── security.tf
├── security_variable.tf
├── nacl.tf
├── nacl_variable.tf
├── eip.tf
├── ec2.tf
├── ec2_variable.tf
├── variable.tf
└── static_var.auto.tfvars
この形だと、ファイルは分かれていても、実行の起点は同じ階層に集まっており、依存関係を含んだ段階検証がやりづらい状態でした。
変更後のイメージ
Workspace/AWS/
├── main.tf
├── variables.tf
├── provider.tf
├── outputs.tf
├── versions.tf
├── static_var.auto.tfvars
├── envs/
│   └── dynamic_var.tfvars
├── modules/
    ├── template/
    ├── vpc/
    │   ├── main.tf
    │   ├── variables.tf
    │   └── outputs.tf
    ├── subnet/
    │   ├── main.tf
    │   ├── variables.tf
    │   └── outputs.tf
    ├── route_table/
    ├── security/
    ├── ec2/
    ├── nacl/
    ├── igw/
    └── eip/
現在は、Workspace/AWS/main.tf が root module となり、ここから modules/ 配下の各moduleを呼び出す形に整理しています。
この変化によって、
- 実行起点が
main.tfに集約された - 各moduleが
main.tf / variables.tf / outputs.tfの単位で責務を持つようになった - VPCのoutputを使ってSubnetを作るような依存解決をroot側で扱えるようになった
という点が大きく改善されています。
特にsecurity moduleでは、CIDR、Prefix List、Security Group参照をそれぞれ扱えるようにし、variables.tf側でも入力ルールをある程度チェックできるようにしています。これにより、詳細設計書由来の値が不正な形で流れ込んだ場合も、比較的早い段階で気づけるようになりました。
LocalStackとAWSを切り替える検証基盤
今回の検証基盤では、Docker上のcommand_runnerコンテナからOpenTofuを実行し、environment=local|prodで接続先を切り替える形にしています。
localではLocalStack向けのendpointを使い、prodでは実AWSに向ける構成です。
この形にしたことで、以下のような使い分けができるようになりました。
- LocalStackで構文や依存関係を高速に確認する
- 実AWSに近い条件でplan/applyを確認する
- 同じOpenTofuコードを使ったまま、環境だけ切り替える
前回の記事でもLocalStackの有効性には触れましたが、今回はそれを
「AIが生成したtfvarsを受け止める検証基盤」
として本格的に組み込んだ点が大きな違いでした。
段階検証しやすくするための工夫
実行はMakefile経由に寄せ、コンテナ内に入らなくても基本操作ができるようにしています。
make up
make init
make plan TFVARS=envs/dynamic_var.tfvars
make apply ENVIRONMENT=prod TFVARS=envs/dynamic_var.tfvars
また、一部の確認ではmodule-*ターゲットも用意しています。
実際には、root moduleに対して-target=module.<name>を指定する部分検証の仕組みです。
この形にした理由は、module間の依存関係を保ったまま、特定のリソース群だけを重点的に確認したかったためです。結果として、
- どのmoduleで入力不足が起きているか
- どのmoduleで名前解決がずれているか
- どのmoduleで環境差分が表面化しているか
を追いやすくなりました。
たとえば作業ログでも、最初にVPC moduleを検証し、その後にSubnet moduleを追加して既存VPCを参照しながら確認する流れが整理されていました。実際にSubnetの作成時には、VPCを作り直すのではなく既存のVPCを参照しながらpublic/private subnetを段階的に追加できており、この構成の利点がはっきり出ています。
今回得られた効果
今回の取り組みによって、詳細設計書からOpenTofuの検証までの流れをかなり一本化できました。
まず、案件ごとに人がゼロから変数ファイルを書く必要が減り、レビュー対象をdynamic_var.tfvarsに集約しやすくなりました。これにより、作業の中心が「手で書くこと」から「設計書と生成結果の差分を確認すること」へ移りつつあります。
次に、OpenTofu側をmodule分割したことで、VPC周り、Subnet周り、Security Group周り、EC2周りといった単位で確認できるようになり、エラーの切り分けがしやすくなりました。特に、VPCやSubnetのようなネットワーク基盤を先に確認し、その上で次のリソースへ進む流れを取りやすくなっています。
さらに、LocalStackとAWSを同じコードベースで切り替えられるようにしたことで、ローカルでの高速検証と実環境での確認を分離せずに進められるようになりました。これにより、AIによる生成結果を検証基盤に載せるまでの導線がかなり短くなりました。
今回の到達点としては、
- 詳細設計書をもとにAIで
dynamic_var.tfvarsを生成する - 生成した変数でOpenTofuのplan/applyまで流せる形にする
- 問題が出た場合も、module単位に近い粒度で確認できる
という、実務に寄せたIaC検証基盤の土台を作れたことが大きな成果でした。
今後の課題
一方で、社員レビューや今回の検証を通じて、今後さらに詰めるべき点も見えてきました。
1つ目は、命名や参照ルールの機械化です。
今回の構成では、Security Group名やVPC関連リソース名のルールがIaC側の想定と完全には一致しないケースがありました。今後は、Prefixや命名規約を設計書から一貫して組み立てられるようにし、手元での調整を減らす必要があります。
2つ目は、tfstateの管理です。
作業ログの中でも、LocalStackとAWSの状態をどう分けるかは早い段階から論点になっていました。実運用を考えると、案件ごとのstate分離、バックエンド設計、共同作業時の競合回避は避けて通れません。
3つ目は、キーペア作成フローの組み込みです。
現状は変数としてkey_nameを扱う形ですが、実際の案件フローに寄せるなら、鍵の作成から関連付けまで含めて再現できた方が運用しやすくなります。
4つ目は、案件単位でのディレクトリ構成の分割です。
今回の構成は検証基盤としては分かりやすい一方で、複数案件を並行して扱う際には、生成物やtfvars、state、テンプレートの責務をより明確に切り分ける必要があります。案件単位の構成に整理することで、レビューや保守もしやすくなるはずです。
今回のプロジェクトは、詳細設計書からAIで変数を生成し、OpenTofuの検証基盤につなげるところまでを主眼にしていました。そのため、これらの課題は次のプロジェクトでより実運用に近づけるための改善ポイントとして取り組んでいく予定です。
まとめ
今回は、詳細設計書の情報をもとにAIでdynamic_var.tfvarsを生成し、そのままOpenTofuの検証基盤に流し込む仕組みを整備しました。
今回特に重要だったのは、
- 設計書をどう抽出するか
- どの粒度でテンプレート化するか
- どの粒度でIaCを分割するか
まで含めて一連の流れとして設計することでした。
次回は、今回見えてきた命名規約の機械化、tfstate管理、キーペア作成フロー、案件単位の構成分離といった課題に取り組み、より実務に耐えられるIaC基盤へ発展させていきたいと考えています。


