
こんにちは、AI_LABの緒方です。
今回は、Opentfofuを用いてさくらのクラウド上にリソースを作成するプロトタイプを構築しました。
以前のプロジェクト「Azure Open AI x OpenTofu で IaCインフラ構築自動化をしてみた」では、 AWS上にEC2インスタンスを作成する前提でプロジェクトを進めましたが、
本プロジェクトではさくらのクラウドのリソースを作るように変更した形です。
また、コスト削減の観点から、自動化に用いるツールはAzure OpenAIではなく、さくらのAI Engineを用いました。 この部分については、API呼び出し部分のコードを変更することで対応しました。
目次
プロジェクトの目的
OpenTofuを用いて、さくらのクラウド上にリソースを作成できるか検証する。
開発環境
- Python
- OpenTofu(Terraform)
- さくらのクラウド
- さくらのAI Engine
実装手順
ディレクトリ構造
project_root/
├── requirements/
│   ├── test.json (要件定義書のサンプルデータ)
├── terraform/
│   ├── main.tf (OSの種類やディスクサイズを設定)
│   ├── security.tf
│   ├── terraform.tfvars (要件定義書にあわせAIが書き換えるtfvarsファイル)
│   └── template.tfvars (tfvarsファイルのテンプレート)
├── main.py              (AI呼び出しスクリプト)
さくらのクラウド Sandbox上へのリソース作成
さくらのクラウド上に実際にリソースを作成すると、当然ながら料金がかかります。
AWSの場合はLocalStackというローカルエミュレータがあり、実際にサーバーを立てることなく検証を行えましたが、さくらのクラウドには同様のツールが存在しません。
一方で、さくらのクラウドではSandboxが提供されており、機能的な制限はあるものの、ここに作るリソースに対しては課金が行われないため、安心して検証を行うことができます。 「さくらのクラウドでTerraformを使ってみる」を参考に作成しました。
各ファイルは以下の通りです。
main.tf
OSの種類など、案件ごとに異なる部分については、環境変数としてtfvarsファイルで指定したものを参照する形にしました。
zone = “tk1v”となっている部分が重要で、ここではSandbox上にリソースを作成するように指示しています。 たとえばzone = “tk1a”とすると、東京第1ゾーンにリソースが作成され、料金が発生します。
network_interface では、security.tf で定義しているセキュリティルールを適用するようにしています。
terraform {
  required_providers {
    sakuracloud = {
      source  = "sacloud/sakuracloud"
      version = "2.16.2"
    }
  }
}

provider "sakuracloud" {
  zone   = "tk1v"
}

variable "password" { default = "himitsunoString" }

# ★ 追加:OS の種類(文字列)を変数化
variable "os_type" {
  type = string
}

# ★ 追加:ディスクサイズを変数化
variable "disk_size" {
  type = number
}

# ★ 追加:main.py で計算して渡す archive ID 変数
variable "archive_id" {
  type = string
}

resource "sakuracloud_disk" "example_disk" {
  name              = "example1_disk"

  # ★ test.tfvars の size を反映
  size              = var.disk_size

  plan              = "ssd"
  connector         = "virtio"

  # OS → archive_id の変換結果
  source_archive_id = var.archive_id
}

resource "sakuracloud_switch" "example1_sw" {
  name = "exp_sw"
}

resource "sakuracloud_server" "example1_srv" {
  name        = "example1_srv"
  disks       = [sakuracloud_disk.example_disk.id]
  core        = 1
  memory      = 1
  description = "Sandbox test server with selected OS"

  network_interface {
    upstream         = sakuracloud_switch.example1_sw.id
    packet_filter_id = sakuracloud_packet_filter.example_pf.id
  }

  disk_edit_parameter {
    hostname        = "example"
    password        = var.password
    disable_pw_auth = true
  }

  tags = ["sandbox_test"]
}
security.tf
とりあえず一般的なセキュリティルールを定めました。
resource "sakuracloud_packet_filter" "example_pf" {
  name        = "example_packet_filter"
  description = "Sandbox test packet filter"

  # SSH(特定IPのみ許可)
  expression {
    protocol       = "tcp"
    destination_port = "22"
    source_network = "118.243.235.67"
    allow          = true
  }

  expression {
    protocol       = "tcp"
    destination_port = "22"
    source_network = "123.226.227.109"
    allow          = true
  }

  # HTTP(全IPから許可)
  expression {
    protocol         = "tcp"
    destination_port = "80"
    source_network   = "0.0.0.0/0"
    allow            = true
  }

  # HTTPS(全IPから許可)
  expression {
    protocol         = "tcp"
    destination_port = "443"
    source_network   = "0.0.0.0/0"
    allow            = true
  }

  # HTTP Alternative(ポート8080)
  expression {
    protocol         = "tcp"
    destination_port = "8080"
    source_network   = "118.243.235.67"
    allow            = true
  }

  expression {
    protocol         = "tcp"
    destination_port = "8080"
    source_network   = "123.226.227.109"
    allow            = true
  }

  # 全アウトバウンド許可
  expression {
    protocol = "ip"
    allow    = true
  }
}
template.tfvars
AIにterraform.tfvarsを書かせる上で、適切な形式で書けるようにテンプレートを用意しました。
ちなみに、archive_idの数値はAlmaLinux 9.6のものであり、CentOSのものではありません(このファイルの設定は反映されないので、修正していません)。
os_type = "CentOS"
disk_size = 100
archive_id = "113701786893"
terraform.tfvars
内容はAIが書いてくれるので、ファイルの作成だけしておきます。
main.py
- 要件定義書を読み込み、terraform.tfvarsを生成するスクリプトです。
- 8~10行目の.envのパスは適切に修正してください。 .envには SAKURA_AI_TOKEN= のみ定義しておけば良いです。
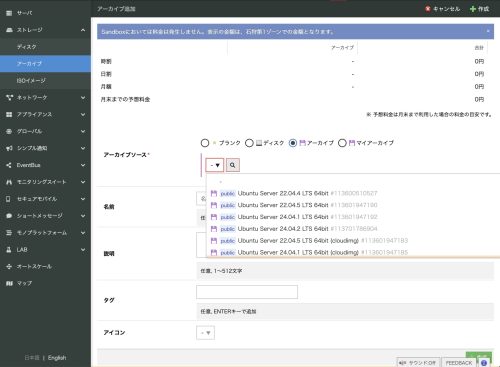
・候補となるOSについては、102行目以降の辞書にアーカイブIDを登録しておきます。 アーカイブIDは、「アーカイブを追加」から確認可能です。
import json
import requests
import os
import re
from dotenv import load_dotenv


# workspace/.env をロード
from pathlib import Path
env_path = Path(__file__).resolve().parents[1] / ".env"
load_dotenv(dotenv_path=env_path)


# ============================================================
#  AI に要件定義書 + tfvarsテンプレートを渡し、新しい.tfvars内容を生成
# ============================================================
def generate_tfvars(requirements_text: str, template_text: str) -> str:
   """
   requirements_text: requirements/test.json の内容(文字列)
   template_text: terraform/template_tfvars の内容(文字列)
   return: AI が生成した terraform.tfvars の文字列
   """


   url = "https://api.ai.sakura.ad.jp/v1/chat/completions"


   headers = {
       "Accept": "application/json",
       "Authorization": f"Bearer {os.getenv('SAKURA_AI_TOKEN')}",  # Token を環境変数で管理推奨
       "Content-Type": "application/json",
   }


   # AI に渡すプロンプト
   prompt = f"""
あなたはTerraform tfvars生成の専門家です。


以下は要件定義書です:
{requirements_text}


以下は tfvars のテンプレートです:
{template_text}


上記の情報にもとづき、Terraform の tfvars を生成してください。


注意点:
- archive_id は、適切な archive_id を推定して埋める必要はありません。(main.py 側で処理するため)
- 出力は tfvars ファイルとしてそのまま保存できる形式にしてください。
"""


   payload = {
       "model": "gpt-oss-120b",
       "messages": [
           {"role": "system", "content": "あなたは専門的なTerraformエンジニアです。出力はすべて日本語ではなく、純粋なtfvars形式で返してください。"},
           {"role": "user", "content": prompt},
       ],
       "temperature": 0,
       "max_tokens": 800,
       "stream": False,
   }


   response = requests.post(url, headers=headers, json=payload)
   response.raise_for_status()


   data = response.json()


   # 生成されたtfvarsを取り出す
   return data["choices"][0]["message"]["content"]


# ============================================================
# Requirements(test.json)を読み込む
# ============================================================
def load_requirements() -> str:
   req_path = Path("./requirements/test.json")
   if not req_path.exists():
       raise FileNotFoundError(f"要件定義書が見つかりません: {req_path}")


   return req_path.read_text(encoding="utf-8")


# ============================================================
# tfvars テンプレートを読み込む
# ============================================================
def load_tfvars_template() -> str:
   template_path = Path("./terraform/template.tfvars")
   if not template_path.exists():
       raise FileNotFoundError(f"tfvarsテンプレートが見つかりません: {template_path}")


   return template_path.read_text(encoding="utf-8")


# ============================================================
# tfvars を書き込む
# ============================================================
def save_tfvars(content: str):
   output_path = Path("./terraform/terraform.tfvars")
   output_path.write_text(content, encoding="utf-8")
   print(f"terraform.tfvars を生成しました: {output_path}")


# ============================================================
# terraform.tfvarsについて、os_typeに合わせてarchive_idに適切な値を入れる
# ============================================================


#”AlmaLinux9.6以外のOSについては、同様にアーカイブIDを辞書登録します。”
os_type_to_archive_id = {
   "AlmaLinux9.6": "113701786893",
   "XXX": "000011112222",
   "YYY": "333344445555",
}


def inject_archive_id(tfvars_path: Path):
   """
   tfvars_path: terraform.tfvars の Path オブジェクト
   os_type_to_archive_id: グローバル辞書参照
   """
   content = tfvars_path.read_text(encoding="utf-8")


   # os_type の値を正規表現で取得
   match = re.search(r'os_type\s*=\s*"([^"]+)"', content)
   if not match:
       print("os_type が見つかりませんでした。archive_id は更新されません。")
       return


   os_type = match.group(1)
   archive_id = os_type_to_archive_id.get(os_type)
   if not archive_id:
       print(f"os_type '{os_type}' に対応する archive_id が未定義です。")
       return


   # archive_id 行を書き換え、もし存在しなければ追加
   if "archive_id" in content:
       content = re.sub(r'archive_id\s*=\s*"[^"]+"', f'archive_id = "{archive_id}"', content)
   else:
       content += f'\narchive_id = "{archive_id}"\n'


   # 書き戻す
   tfvars_path.write_text(content, encoding="utf-8")
   print(f"archive_id を設定しました: {archive_id}")


# ============================================================
# メイン処理
# ============================================================
def main():
   print("=== Sakura Terraform tfvars 生成ツール ===")


   # ① 要件定義を読み込む
   requirements_text = load_requirements()


   # ② テンプレートを読み込む
   template_text = load_tfvars_template()


   # ③ AI による新しい tfvars 生成
   try:
       new_tfvars_text = generate_tfvars(requirements_text, template_text)
   except Exception as e:
       print(f"AI生成中にエラーが発生しました: {e}")
       return


   if not new_tfvars_text:
       print("AI生成結果が空のため、test.tfvars を更新しませんでした。")
       return


   # ④ 出力ファイルへ書き込み
   save_tfvars(new_tfvars_text)


   # ⑤ archive_id を埋め込む
   inject_archive_id(Path("./terraform/terraform.tfvars"))


if __name__ == "__main__":
   main()
実行方法
さくらのAIによる要件抽出と tfvars 生成
.envの以下の部分を埋めます。
# --- さくらのAI ---
SAKURA_AI_TOKEN=
続いて、sakuraディレクトリでPythonスクリプトを実行します。
root@105c3b4560a9:/workspace/sakura# python3 main.py
workspace/sakura/terraform/terraform.tfvarsが更新されます。
OpenTofuの実行
生成された terraform.tfvars をもとに、OpenTofu で環境を構築します:
root@105c3b4560a9:/workspace/sakura# cd terraform
root@105c3b4560a9:/workspace/sakura/terraform# export SAKURACLOUD_ACCESS_TOKEN="<アクセストークン>"
root@105c3b4560a9:/workspace/sakura/terraform# export SAKURACLOUD_ACCESS_TOKEN_SECRET="<アクセストークンシークレット>"
root@105c3b4560a9:/workspace/sakura/terraform# tofu init
root@105c3b4560a9:/workspace/sakura/terraform# tofu plan
root@105c3b4560a9:/workspace/sakura/terraform# tofu apply
まとめ
今回のプロジェクトでは、OpenTofuを使ってさくらのクラウド Sandbox上にリソースを作成できることを確認しました。
とりあえずの試作段階であり、まだまだ改良の余地があるものの、 AIによる要件定義書からの自動取得技術と組み合わせることで、さくらのクラウドについてもサーバー構築の自動化ができるようになりそうです。


