
こんにちは。AILabの堂上拓です。
前回はMicrosaas開発シリーズとして、複数の書類が連結されたPDFを「書類単位」に自動分割するパイプラインに、ユーザーのページ分割操作(分割・結合)からの境界学習を組み込むプロトタイプを実装しました。
今回はその続編として、同じパイプラインにフィールド値(利用者名・書類タイトル・要介護度など)の修正学習を組み込むプロトタイプを実装しました。
このプロトタイプは、ユーザーが一度行ったフィールド値の訂正を、その書類のレイアウトに紐付けて学習データとしてDBに蓄積し、次回以降の同じフォーマットのPDF処理時にLLMの抽出結果を自動的に上書き補正することで、毎回同じ訂正を繰り返す手間を漸進的に減らしていく仕組みです。
さらに今回から、一度学習した書類レイアウトが別のPDFの中に内包されているケースにも対応しました。学習は「書類単位」で行っているため、複数の書類が連結されたPDFの構成(順番・組み合わせ)が変わっても、過去に学習済みの書類であれば、ページ分割とフィールド補正を自動的に再現できます。後述の出力結果では、この内包ケースを実例で示します。
OCRとLLMによる抽出は、同じ事業所が繰り返し提出する定型書類でも、毎回同じ箇所を同じように誤抽出してしまうことがあります。氏名のラベル混入(「管理者伊藤洋子」)、書類タイトルの表記揺れ、要介護度の取りこぼし等、、、これらをユーザーが毎回手で直すのは非効率です。
今回開発したプロトタイプは、その訂正をOCR周辺文字列のマッチングと座標フォールバックで自動再現するものです。
本プロトタイプの特徴:学習した修正もLLMに頼らない
前回と一貫して、本プロトタイプの最大の特徴は、学習した修正の再現を、LLMに頼らず決定論的なアルゴリズムで実現している点です。
LLMで「前回こう直したから今回もこう直して」と指示する方式も考えられますが、本プロトタイプではあえてLLMを使わず、以下の理由からOCRテキスト上の周辺文字列マッチ + ファジー一致 + 座標フォールバックという構造的アプローチを採用しました。
LLMを使わないメリット:
- 低コスト: 学習が増えても追加のLLM呼び出しは発生しない。運用コストは一定
- 判定根拠が説明可能: 「どの履歴の、どの前後文字列にマッチして、どの値に補正したか」をログから追える
- 安定した出力: 同じ書類には常に同じ補正が適用される(LLMの「揺れ」がない)
- 誤伝播しにくい: OCRに裏付けのない値は焼き付けない、というガードを明示的に置ける
- 段階的に学習が積み上がる: ユーザー修正のたびに履歴がDBに蓄積され、補正精度が漸進的に上がる
本プロトタイプで使用している主な技術:
- rapidfuzz: 修正値がOCRテキストに存在するかのファジー判定、周辺文字列マッチング
- 異体字・OCR誤認の正規化: 「髙→高」などの正規化を通してマスター突合の取りこぼしを防ぐ
学習・適用の中心部(修正履歴の記録、前後文字列の切り出し、マスター内包補正)は、文字列演算と統計処理だけで成立する決定論的なアルゴリズムです。
それでは開発の経緯とプロトタイプの仕組みについてご説明します。
開発環境
本プロトタイプで追加・使用した技術スタックは以下のとおりです。
rapidfuzz(高速ファジーマッチ)
修正後の値がそもそもOCRテキスト上に存在するか(=学習材料にできるか)の判定や、適用時の周辺文字列マッチングに使用しています。OCRの文字つぶれや1〜2文字の誤認を許容しつつ、書類に存在しない手入力値を弾くために partial_ratio を活用しています。
処理フロー概要
本プロトタイプは、前回の境界学習と同じく「学習サイクル(人間視点)」と「適用サイクル(システム視点)」の2つで構成されます。両者は 学習DB を介してつながり、人間の修正がDBに蓄積され、次回のシステム処理で参照される、というループを描きます。
① 適用サイクル(システム視点・全自動)
新規PDFをアップロードすると、最初から最後まで自動で処理されます。人間の判断は一切入りません。
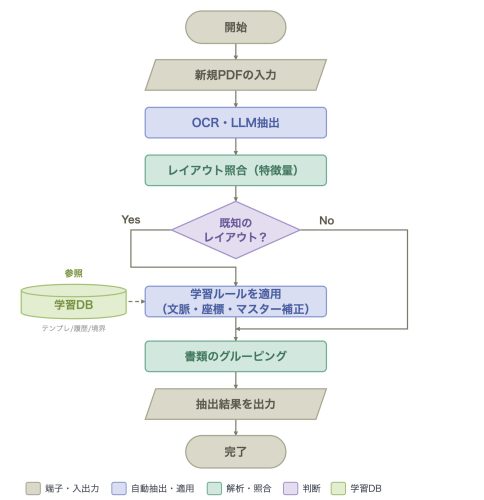
文章で書き下すと、処理ステップは以下のとおりです:
- OCR・LLM抽出 → PDFをOCRし、LLMでフィールドを抽出
- レイアウト照合(特徴量) → 各ページの特徴量から書類シグネチャを作り、過去のテンプレートと照合(前回実装した部分)
- 既知のレイアウト判定 → マッチすれば学習ルールを適用、未マッチならスキップしてグルーピングへ
- 修正ルールの適用 → マッチしたテンプレの履歴から、OCRテキストや座標を手がかりに値を抽出し、LLM結果を上書き
- マスター補正 → 抽出値にラベル等が混入していればマスター候補で正準表記に補正
- 書類のグルーピング → 抽出結果を出力
このとき 学習DB(テンプレート / 修正履歴 / 境界サンプル)を参照して、上記の照合・適用・グルーピングを補正します。
② 学習サイクル(人間視点・修正を起点に蓄積)
出力結果を人間が直すと、その内容が 学習DB へ蓄積され、次回の自動処理に活かされます。
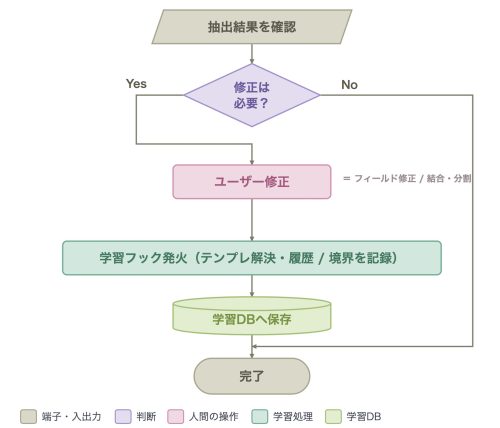
文章で書き下すと、処理ステップは以下のとおりです:
- ユーザー修正の検知 → ユーザーがUIでフィールドを訂正、または書類を結合 / 分割したのをフックで捕捉
- テンプレート解決 → そのItemが属するLayoutTemplate(書類レイアウト)を逆引き
- 修正履歴の記録 → 修正前後の値 + OCR上の前後文字列 + 座標を
correction_field_historiesに保存(結合 / 分割は境界サンプルを記録) - 集計の更新 →
correction_analytics(共有DB)の修正回数を +1 - 学習DBへ保存 → 以降の適用サイクルで参照される
以下では、学習(キャプチャ)と適用に分けて詳しく説明していきます。
学習:ユーザー修正を履歴に残す
どのフィールドを学習するか
学習対象は、書類から抽出する主要フィールドです。Item の属性名でマッピングを定義しています。
# 学習対象フィールド → Item 属性名のマッピング
LEARNABLE_FIELD_MAP: dict[str, str] = {
    "user_name": "user_name",
    "document_title": "document_title",
    "subtitle": "subtitle",
    "date": "date",
    "item_name": "item_name",
    "care_level": "care_level",
    "burden_ratio": "burden_ratio",
    "insured_number": "insured_number",
    "insurer_number": "insurer_number",
    "address": "address",
    "facility_name": "facility_name",
    "home_care_support_office": "home_care_support_office",
}
修正前後の「値」と「前後文字列」を記録する
学習の核は、修正後の値そのものだけでなく、OCRテキスト上でその値の前後に何が書かれているか(コンテキスト)を一緒に記録する点です。次回、別の利用者の同フォーマット書類でも、「このラベルの後ろに来る値」として位置を特定できるようにするためです。
値の前後 CONTEXT_WINDOW = 25 文字を切り出して保存します。
# 値の前後で切り出す文字数
CONTEXT_WINDOW = 25
# OCR から前後文字列を探す際の値の最小長(短すぎると誤マッチしやすい)
MIN_LEARN_VALUE_LEN = 2
# (layout_template_id, field_name) ごとの最大保持件数。
# 1 = 最新の修正のみ保持する。ユーザーが修正→(誤りに気づいて)再修正した場合に、
# 誤った方の修正を学習データとして残さないため、新しい修正で過去の履歴を上書き
# (古い行を削除)する。
MAX_HISTORY_PER_FIELD = 1
履歴は (テンプレート × フィールド) ごとに最新1件のみ保持します。「修正→誤りに気づいて再修正」したとき、誤った方を学習し続けないための割り切りです。
OCRに存在しない値は学習しない
ユーザーが入力した値が、別ソースからの手入力やマスター選択で挿入されたもので、そもそも書類のOCRテキスト上に存在しないことがあります。これを学習してしまうと、次回の周辺文字列マッチや座標マッチが必ず外れます。
そこで、修正後の値がOCR上に「ある」と見なせるか(ファジー一致率 MIN_OCR_PRESENCE_RATIO = 60.0 以上)をチェックし、満たさなければ履歴のINSERTをスキップします。
# 修正後の値が OCR テキスト上に「ある」と見なす partial fuzzy 一致の閾値。
# 5文字の値で3文字以上一致 = 60% を採用。OCR の文字つぶれ・1〜2文字誤認は許容
# するが、書類にそもそも存在しない値(別ソース手入力やマスター選択で挿入された値)
# は学習材料にできないため、history 行の INSERT をスキップする。
# 修正回数(correction_count)は別途インクリメントされ続けるので、「抽出困難な
# フィールド」として可視化グラフには現れる。
MIN_OCR_PRESENCE_RATIO = 60.0
存在ガードでINSERTをスキップしても、correction_count(修正回数)は加算し続けます。これにより「学習はできないが、よく直されている=抽出が難しいフィールド」を後述の可視化で把握できます。
FK経由のフィールドは「回数だけ」数える
ケアマネジャーや居宅介護支援事業所のように、Item 側が文字列ではなくID(FK)で正規化されているフィールドは、文字列ベースの再抽出ルールを学習できません(マスター名に敬称・表記揺れがあるため)。これらは履歴を作らず、修正回数のカウントだけ行います。
FK_COUNT_ONLY_FIELDS: dict[str, str] = {
    "care_manager_id": "care_manager_name",
    "home_care_office_id": "home_care_support_office",
}
座標フォールバック用の領域も記録する
手書きや低品質スキャンで周辺文字列マッチが当たらないケースに備え、修正後の値がOCR行に一致した場合は、その行のポリゴンから矩形領域(region)を coordinate_rule_data として記録します。
{
  "page_number": 1,
  "region": { "left": 0.1, "top": 0.2, "right": 0.5, "bottom": 0.24 },
  "ocr_line_content": "氏名 伊藤洋子",
  "propagate": "all_pages"
}
照合は「完全一致」または「内包(値が行に含まれる)」のみとし、逆方向の部分一致は除外しています。たとえば要介護度「要介護1」に対し、OCRの断片「要介護」やページ番号「1」だけに当たって無関係な領域を拾うのを防ぐためです。
学習フックは「薄く・落ちない」
学習はあくまで副次的な処理です。フィールド修正のメインフロー(Item更新)を止めないよう、薄いフック関数で呼び出し、内部で全例外を吸収します。
def safe_learn_from_item_update(
    session: Session,
    item: Item,
    before_diff: dict[str, Any],
    after_diff: dict[str, Any],
) -> None:
    """item 更新時の値学習を呼び出し、失敗してもメインフローに伝播させない。"""
    if not before_diff and not after_diff:
        return
    try:
        ValueLearningService.learn_from_item_update(
            session=session,
            item=item,
            before_diff=before_diff,
            after_diff=after_diff,
        )
    except Exception as exc:
        logger.warning("Value learning failed (non-critical): %s", exc)
学習処理が何らかの理由で失敗しても、ユーザーのフィールド修正自体は成功させる必要があります。そのため例外はWARNINGログだけ残して握りつぶし、メインフローには伝播させない設計にしています。
適用:学習した修正を新規PDFに上書きする
新規PDFがレイアウトマッチング(前回実装)で既存テンプレートにマッチすると、そのテンプレに紐づく修正履歴を使って、LLM抽出結果を上書き補正します。この処理は ApplyLearnedRulesStep として、レイアウトマッチングの直後・グルーピングの前にパイプラインへ挿入されています。
2段構え:コンテキスト抽出 → 座標フォールバック
フィールドごとに、以下の2段階で値を決定します。
- コンテキスト抽出: 履歴に保存した「修正後の値の前後文字列」を手がかりに、テンプレ範囲の連結OCRテキストから値を切り出す
- 座標フォールバック: コンテキストで取れなかった場合のみ、
coordinate_rule_dataの領域に最も近いOCR行から値を取得する
コンテキスト検索は、学習時と同じくテンプレ範囲の全ページOCRを連結したテキストに対して行います(書類が複数ページにまたがり、値とラベルが別ページにあるケースに対応)。
マスター補正:ラベル混入を正準表記に直す
OCRから切り出した値には、ラベルや余分な前後文字が混入することがあります(「管理者伊藤洋子」など)。document_title 以外のフィールドは、抽出値をマスター候補と突合し、内包される最長のマスター文字列を正準表記として採用します。
def refine_against_masters(
    extracted: str,
    master_values: Sequence[str | None],
) -> str | None:
    """抽出値にマスター文字列が内包されていれば、そのマスターの正準表記を返す。

    正規化(スペース除去 + 異体字/既知の OCR 誤認識文字の補正)を通した上で、抽出値に
    内包される最長マスターを採用する(完全一致も内包の一種)。逆向きの欠損補完
    (抽出値がマスターに内包される側)や編集距離ベースの近似補正は行わない。

    例:
        >>> refine_against_masters("管理者伊藤洋子", ["伊藤洋子", "田中花子"])
        '伊藤洋子'
        >>> refine_against_masters("髙橋健太", ["高橋健太"])  # 異体字正規化で一致
        '高橋健太'
        >>> refine_against_masters("伊藤", ["伊藤洋子", "伊藤健太"])  # 補完しない
        # None
    """
    ...
逆方向の補完(抽出値「伊藤」をマスター「伊藤洋子」に勝手に補う)や編集距離ベースの近似補正はあえて行いません。「田中一郎」を「田口一郎」に化けさせるような誤補正を避けるためです。同じ長さで複数のマスターが内包される場合も、曖昧として補正しません。
内包判定の前段:文字列正規化
内包判定をそのまま生の文字列で行うと、「髙橋」と「高橋」のような異体字や、OCRの既知の誤認識でマッチを取りこぼします。そこで、抽出値・マスター候補の双方を専用の正規化関数 normalize_name_for_matching に通してから内包判定を行います。この正規化は実装側で以下を行います。
- スペース除去: 全角・半角スペースを取り除く
- 異体字の統一: 「髙→高」などの異体字を正規表記に寄せる
- 既知のOCR誤認識文字の補正: 誤読されやすい文字を正しい文字へ置換する
正規化はあくまでマッチング用であり、correction_field_histories には正規化前の元の値を保存します。返すのもマスター側の元表記なので、summary_json はマスターの正準表記に揃い、後続のマスター突合がそのまま通ります。
document_title だけはマスター補正をスキップします。マスター正規化済みのカテゴリ値に補正をかけると、「居宅サービス計画書(2)」の分割連番のような接尾辞が落ちてしまうためです。
適用ガード:OCRに裏付けのない値は焼き付けない
コンテキスト・座標のいずれでも値が取れなかった場合は、何も適用しません。学習値を無条件に焼き付けると、たまたまレイアウトが似ているだけの別書類に誤った値を伝播させてしまうためです。document_title も例外ではなく、OCRの裏付けがなければ復元しません。
集計・可視化:どの項目がよく直されているか
蓄積した修正回数は、テナント横断で「どの書類のどの項目が修正されやすいか」を集計できます。これは抽出精度改善の優先順位付けに使う、開発・分析用の機能です(本番UIには露出しません)。
修正回数の集計と、修正データの可視化(積み上げ棒グラフ・履歴ダンプ)をCLIで提供しています。
# 書類タイトル別×項目別の累計修正回数を積み上げ棒グラフ(SVG)で出力
docker compose exec backend python -m app.services.extraction_feedback.correction_visualizer graph

# 1修正=1行で履歴をダンプ(前後コンテキスト付き)
docker compose exec backend python -m app.services.extraction_feedback.correction_visualizer histories --field user_name


出力結果
実際に、複数の書類が連結されたPDFを2回投入してみます。
投入するPDFは、いずれも複数の書類が1ファイルに連結された構成です。ここでは4種類の書類を A・B・C・D と表記し、括弧内の数字は各書類のページ数を表します。
- 1回目:
sample2 (1).pdf… A(3) → B(2) → C(6) → D(2)(全13ページ) - 2回目:
sample1 (1).pdf… D(2) → C(6)(全8ページ)
注目していただきたいのは、2回目の sample1 (1).pdf を構成する書類 D・C が、1回目の sample2 (1).pdf の中にすでに含まれていた点です。つまり「一度読み取ったレイアウトが、別のPDFの中に内包されている」ケースであり、今回から対応した部分です。
書類のどの箇所の名前を利用者として登録するかは、その書類を使用するクライアントによって異なると考えられます。今回は例として、Cの書類で「管理者」と記載されている部分を利用者としました。以下順に、sample2・sample1それぞれに含まれるCの書類について、1・2ページ目を示します。

1ページ目

2ページ目

1ページ目

2ページ目
1回目:誤抽出 → ユーザーが訂正 → 履歴に保存
1回目は学習データがないため、LLMによるページ分割とフィールド抽出の結果がそのまま表示されます。氏名にラベルが混入していたり、書類タイトルが揺れていたり、ページ分割が書類単位で割れていなかったりします。
1回目の修正前

ユーザーがUI上で、以下の訂正を行います。
- ページ分割の修正:
1,2-3→1-3、6-10,11→6-11に結合 4-5の書類タイトルを「契約約款」に変更4-5の利用者名を空欄に変更6-11の利用者名を「髙橋健太」に変更(マスターデータから選択)
1回目の修正後

この時点で、各書類のレイアウトに紐づけて、ページ分割(境界)の修正と、各フィールドの修正前後の値・前後コンテキスト・座標が学習データとして保存されます。
2回目:内包された書類の自動補正
次に、2回目として sample1 (1).pdf(D → C)を投入します。これらの書類D・Cは、1回目の sample2 (1).pdf の中に内包されていたものですが、学習は書類単位で行っているため、別のPDFに組み替えられ、出現順や前後の書類が変わっても、ページ分割とカラム(フィールド)取得が適切に再現されます。

このように、書類単位で学習することで、内包された書類D・Cに対して、ユーザーが何も訂正していないにもかかわらず、1回目で確定させたページ分割の結合ルールと各フィールドの補正(利用者名のラベル除去・空欄化・マスター値への補正)が自動的に反映され、ページ分割とカラム取得が適切にできていることがわかります。
対応できるケース
本プロトタイプが対応できるケースを整理すると以下のとおりです:
| ケース | 1回目の状態 | 2回目の自動反映 |
|---|---|---|
| 学習済みの書類が別PDFに内包される(今回から対応) | ユーザーがページ分割・各フィールドを訂正 | 書類単位の学習により、出現順・組み合わせが変わってもページ分割とフィールド補正を再現 |
| 氏名にラベルが混入する書類(「管理者◯◯」等) | ユーザーが氏名だけに訂正 | マスター内包補正でラベルを自動除去 |
| 書類タイトルの誤抽出・表記揺れ | ユーザーが正しいタイトルに訂正 | 前後コンテキストから正しいタイトルを再抽出 |
| 要介護度・負担割合などの取りこぼし | ユーザーが値を入力(OCR上に存在する場合) | 周辺文字列マッチで自動補完 |
| 手書き・低品質スキャンで周辺文字列が当たらない | ユーザーが訂正(OCR行に一致する場合) | 座標フォールバックで領域から抽出 |
| OCRに存在しない手入力値 | 学習はスキップ(存在ガード) | 自動補正されない(修正回数のみ集計) |
主要な閾値
本プロトタイプで使っている主要な閾値・定数を一覧にしておきます。
| 閾値・定数 | 値 | 用途 |
|---|---|---|
| 前後コンテキスト文字数 | 25 文字 | 値の前後を切り出して保存する範囲 |
| 履歴の保持件数 | 1 件 | テンプレ×フィールドごとに最新のみ保持 |
| OCR存在ファジー一致率 | 60.0 | 履歴記録に必要な、修正値のOCR存在判定 |
| 適用時コンテキスト一致閾値 | 75.0 | 適用時に周辺文字列マッチを採用する下限 |
| マスター内包補正の最小文字数 | 2 | 1文字マスターの誤補正を防ぐ下限 |
| 書類同一性マッチ閾値 | 0.80 | (前回実装)既存書類と判定する総合スコア下限 |
| サブシーケンスマッチ閾値 | 0.85 | (前回実装)部分一致で既存テンプレを再利用する下限 |
今後の展望
現状のプロトタイプには以下の課題があり、今後の改善を検討しています。
履歴保持件数の見直し
現状は (テンプレ × フィールド) ごとに最新1件のみ保持していますが、複数の表記パターン(例:ラベルの有無が混在する書類)を学習させたい場合、最新N件を保持して多数決で補正する方式も検討しています。
テンプレートマッチングのコスト
前回も触れたとおり、テンプレートが増えるとマッチング比較コストが線形に増加します。フィールド学習が乗ることで1テンプレあたりの価値は上がりますが、テンプレートの統合・優先度付け・アーカイブ化といった整理は引き続き課題です。


