
こんにちは。AI Labの堂上拓です。
今回は、数ヶ月前に開発した文書比較AIのコスト最適化と機能アップグレードについて、その技術的な詳細をご紹介します。
本プロジェクトの目的は、AIによる文書比較ツールをより実用的なものに改良することです。具体的には、以下の2つの課題解決を目指しました。
・機能改善
従来版では、変更箇所がページをまたぐと正しく比較できないという課題がありました。
・コスト最適化
将来的な運用を見据え、AIの処理コストを大幅に削減する必要がありました。
この記事では、これらの目的を達成した新しい開発プロセスについて詳しく解説します。
目次
開発環境
精度の検証を重ねた結果、LLMとOCRには以下のモデルを採用し、加えてPythonの強力なライブラリを複数活用して開発を進めました。
Azure OpenAI o4-mini
コスト最適化の要として、LLMを従来のGPT-4.1からo4-miniへ移行しました。これにより、AI処理コストを約45%削減することに成功しました。下の図は両モデルの出力結果を比較したものですが、精度の面で大きな遜色がないことがお分かりいただけると思います。

Azure Document Intelligence
PDFからの文字抽出には、引き続きAzure Document Intelligenceを使用しました。このモデルは、文字認識の精度と処理速度において圧倒的な性能を誇っており、本プロジェクトに不可欠なツールです。
Python
差分検出や画像処理など、高度な処理を効率的に実装するため、多彩なライブラリを持つPythonを活用しました。
環境構築
開発をスムーズに進めるための環境構築とプロジェクトの構造について説明します。
1. 仮想環境の構築と依存関係のインストール
プロジェクトごとにライブラリのバージョンを独立させるため、Pythonの仮想環境を構築します。
python3 -m venv venv

source ./venv/bin/activate

pip install -r requirements.txt
2. プロジェクトのモジュール構造
アプリケーションは機能ごとにファイルを分割し、保守性を高めています。
入力データ
・比較したい2つのPDFファイルをdoc-compare-ai/input/に保存します。
・改訂前をbefore.pdf、改訂後をafter.pdfというファイル名にしてください。
出力データ
・差分がハイライトされた2つのPDFファイルと、変更点をまとめた新旧対照表(Excel形式)がoutput/final/に、出力されます。
コード
・ocr_to_json.py:PDFをOCR処理し、テキストと構造(ヘッダー、フッター等)をJSON形式で抽出します。
・pdf_to_jpeg.py:PDFの各ページをJPEG画像に変換します。
・generate_diff.py:差分を検出し、JPEG画像上にハイライトを描画します。
・generate_diff_csv.py:差分情報から新旧対照表を自動生成します。
・concatenate_images.py:ハイライト済みのJPEG画像を結合し、最終的なPDFファイルを作成します。
開発プロセス
今回の最大のテーマは、ページ単位でしか比較できなかった旧機能を抜本的に改善することでした。
・旧プロセスの課題
PDFをページごとに分割・画像化 → ページごとにOCR → ページごとに差分検出
この方法では、文章の追加や削除によってテキストが次のページにずれると、正しく差分を追跡できませんでした。
・新プロセスの改善点
PDF全体のOCR → 全文テキストで差分検出 → 差分箇所を特定し、画像にハイライト
この新しいフローでは、まず文書全体を構造的に解析することで、ページをまたぐ変更にも対応できるようになりました。
この飛躍的な精度向上を可能にしたのが、Azure Document Intelligenceの高度な機能です。単に文字を抽出するだけでなく、テキストが「タイトル」「ヘッダー」「フッター」「本文」といったどの部分に属するかをroleとして識別してくれます。この構造情報を利用することで、文書全体を一つの連続したテキストとして捉え、ページという物理的な制約を超えた比較が実現しました。
1. OCRで文書構造を解析 (ocr_to_json.py)
Azure Document Intelligenceを用いて、PDF内のテキストをその役割や位置情報と共にJSON形式で抽出します。これにより、文書を単なる文字列の集合ではなく、意味のある構造体として扱えるようになります。
・ocr_to_json.py
import os
import json
from pathlib import Path
from dotenv import load_dotenv
from azure.core.credentials import AzureKeyCredential
from azure.ai.documentintelligence import DocumentIntelligenceClient
import shutil

load_dotenv()
endpoint = os.getenv("AZURE_DOCUMENT_INTELLIGENCE_ENDPOINT")
key = os.getenv("AZURE_DOCUMENT_INTELLIGENCE_KEY")

client = DocumentIntelligenceClient(endpoint=endpoint, credential=AzureKeyCredential(key))

def clear_dir(path: Path):
    """ディレクトリを空にして作り直す"""
    if path.exists():
        shutil.rmtree(path)
    path.mkdir(parents=True, exist_ok=True)

def analyze_pdf(pdf_path: str):
    """PDF を Azure Document Intelligence で解析して結果を返す"""
    with open(pdf_path, "rb") as f:
        poller = client.begin_analyze_document(
            model_id="prebuilt-layout",
            body=f,
            content_type="application/pdf"
        )
    result = poller.result()
    return result.as_dict()

def main():
    before_pdf = "input/before.pdf"
    after_pdf = "input/after.pdf"

    json_output_dir = Path("output/json")
    clear_dir(json_output_dir)

    before_result = analyze_pdf(before_pdf)
    before_json_path = json_output_dir / "before_full.json"
    with open(before_json_path, "w", encoding="utf-8") as f:
        json.dump(before_result, f, ensure_ascii=False, indent=2)
    print(f"保存しました: {before_json_path}")

    after_result = analyze_pdf(after_pdf)
    after_json_path = json_output_dir / "after_full.json"
    with open(after_json_path, "w", encoding="utf-8") as f:
        json.dump(after_result, f, ensure_ascii=False, indent=2)
    print(f"保存しました: {after_json_path}")

if __name__ == "__main__":
    main()
2. pdfをjpegに変換する(pdf_to_jpeg.py)
後の工程で画像上にハイライトを描画するため、PDFの各ページをJPEG画像に変換します。これは、画像処理ライブラリ(OpenCV)がPDFを直接扱えないための準備ステップです。
・pdf_to_jpeg.py
import fitz
from pathlib import Path
import shutil

def clear_output_dir(path):
    path = Path(path)
    if path.exists():
        shutil.rmtree(path)
    path.mkdir(parents=True, exist_ok=True)

def convert_pdf_to_jpegs(pdf_path, output_dir, image_type="before", dpi=200):
    pdf_path = Path(pdf_path)
    output_dir = Path(output_dir)
    doc = fitz.open(pdf_path)
    saved_files = []

    for i, page in enumerate(doc):
        pix = page.get_pixmap(dpi=dpi)
        filename = output_dir / f"page_{i+1}_{image_type}.jpg"
        output_dir.mkdir(parents=True, exist_ok=True)
        pix.save(str(filename))
        print(f"{filename}に画像を保存しました")
        saved_files.append(str(filename))

    return saved_files

def main():
    before_pdf = "input/before.pdf"
    after_pdf = "input/after.pdf"
    before_output = "output/before/images"
    after_output = "output/after/images"
    clear_output_dir(before_output)
    clear_output_dir(after_output)
    before_images = convert_pdf_to_jpegs(before_pdf, before_output, "before")
    after_images = convert_pdf_to_jpegs(after_pdf, after_output, "after")
    print("JPEG変換が完了しました")

if __name__ == "__main__":
    main()
3. ハイライト画像生成(generate_diff.py)
このステップは本プロジェクトの中核部分であり、OCR結果から得られたテキスト情報をもとに、差分箇所を正確に特定し、該当領域を画像上でハイライトする処理を行います。ここでは、OCRの誤認識をLLMで補正し、テキスト正規化により比較精度を向上させ、差分領域を検出・描画するまでの一連の流れを実装しています。
(1)LLMによるOCR誤認識の補正
OCR処理では、印字の乱れや画像のノイズなどにより、英単語が誤って認識されるケースが頻発します。例えば以下のように、本来 “varying” である箇所が “varving” と誤って出力される場合があります。
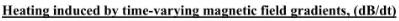

このようなOCR特有の誤字を手動で全て修正するのは現実的ではありません。そこで、generate_diff.py 内では Azure OpenAI Service のLLMを用いて、文脈に基づいた自動補正を行います。
修正処理を担うのは以下の関数です:
def normalize_and_correct_text(words: list[str]) -> list[str]:
この関数では、まず全ての単語を正規化(後述)した上で、LLMに以下のような命令を与えます。
「与えられた単語リストに含まれるスペルミスを修正しなさい。ただし、数字や記号を削除・変更してはいけない。」
これにより、varving → varying のように実際に存在しない単語は自動的に補正され、また文脈的に不自然な単語も正しい形に修正されます。返り値は “corrected_words” というキーを持つJSON形式で受け取ります。この修正を行うことで、OCR誤差が差分検出精度に与える影響を最小化しています。
(2)テキスト正規化による比較精度の向上
次に、比較処理を行う前段階として、文字コードや記号のばらつきを統一する正規化処理を行います。これは、OCR結果では全角/半角の混在や異体字、記号表現の揺れが生じるためです。
例として、温度を表す「°C」と「℃」の違いは、見た目こそ似ていますが別のUnicode文字であるため、単純な文字列比較では「差分」として誤検出されてしまいます。これを防ぐために、次のような正規化を行います:
def normalize_text_for_comparison(text: str) -> str:
    text = text.replace('“', '"').replace('”', '"') \
               .replace('‘', "'").replace('’', "'")
    normalized = mojimoji.zen_to_han(
        unicodedata.normalize('NFKC', text),
        kana=True, ascii=True, digit=True
    )
    return mojimoji.han_to_zen(normalized, kana=False, ascii=False, digit=False)
この処理では以下を統一しています:
・全角/半角統一:英数字・記号などを半角に統一後、必要に応じて再び全角化
・引用符・アポストロフィの正規化:異体字を統一
・NFKC正規化:Unicode表現の差を解消(例:「µ」や「㎜」など)
この段階で、機械的な文字比較がより安定して行える状態になります。
(3)差分領域の検出とハイライト描画
正規化と補正を経たテキストをもとに、calculate_diffs() 関数が差分検出を行います。ここでは difflib.SequenceMatcher を活用し、各段落(paragraph)単位で以下の3種類の差分を分類します:
・replace(変更):既存のテキストが修正・書き換えられた箇所
・insert(追加):新たに挿入された箇所
・delete(削除):削除された箇所
また、段落内の単語情報(位置座標・ページ番号・ポリゴン情報)を保持しているため、単なるテキスト比較ではなく 空間的な差分検出 が可能です。検出結果は、ページごとに all_diffs_by_page に格納されます。
{
  1: {
    "before": [ポリゴン座標群],
    "after":  [ポリゴン座標群]
  },
  2: {
    ...
  }
}
これを基に、generate_highlighted_images() 関数では OpenCV を用いてハイライト画像を生成します。
def draw_differences_on_image(image_path, polygons, color):
    img = cv2.imread(str(image_path))
    overlay = img.copy()
    for poly in polygons:
        pts = normalize_to_pixel(poly)
        cv2.polylines(overlay, [pts], isClosed=True, color=color, thickness=2)
        cv2.fillPoly(overlay, [pts], color)
    cv2.addWeighted(overlay, 0.4, img, 0.6, 0, img)
    return img
・削除箇所(before)は青色 ((0, 0, 255))
・追加箇所(after)は赤色 ((255, 0, 0))
で半透明に重ね合わせて描画されます。これにより、人間の目で見ても一目で差分が確認できる視覚的な出力が得られます。
4. 新旧対照表を作成する(generate_diff_csv.py)
この処理では、検出された差分(テキストの追加・削除・変更)をもとに、AIが自動で内容を要約し、新旧対照表(Excelレポート)を生成します。
Azure OpenAIを利用し、「どの部分が変更されたのか」を自然言語で簡潔にまとめ、Excelで読みやすい形に整形して出力します。
・generate_diff_csv.py
import json
from pathlib import Path
import os
from openai import AzureOpenAI
from dotenv import load_dotenv
import unicodedata
from openpyxl import Workbook
from openpyxl.styles import Alignment
import openpyxl

load_dotenv()

try:
    client = AzureOpenAI(
        api_key=os.getenv("AZURE_OPENAI_API_KEY"),
        api_version=os.getenv("AZURE_OPENAI_VERSION"),
        azure_endpoint=os.getenv("AZURE_OPENAI_ENDPOINT")
    )
    AZURE_OPENAI_DEPLOYMENT_NAME = os.getenv("AZURE_OPENAI_DEPLOYMENT_NAME_MINI")
    #gpt-4.1を使うなら
    # AZURE_OPENAI_DEPLOYMENT_NAME = os.getenv("AZURE_OPENAI_DEPLOYMENT_NAME")
    print("Azure OpenAIクライアントの初期化に成功しました。")

    if not AZURE_OPENAI_DEPLOYMENT_NAME:
        client = None

except Exception as e:
    print(f"Azure OpenAIクライアントの初期化中にエラーが発生しました: {e}")
    client = None
    AZURE_OPENAI_DEPLOYMENT_NAME = None

def clean_response_content(raw: str) -> str:
    """AIモデルから返されたJSON文字列を整形します。"""
    if raw.startswith("```json"):
        raw = raw[len("```json"):].strip()
    if raw.endswith("```"):
        raw = raw[:-len("```")].strip()
    return raw

def summarize_difference_with_ai(before_text: str, after_text: str, diff_type: str, before_pages: list, after_pages: list) -> dict:
    """Azure OpenAIを使用して、検出された単一の差分を要約し、フォーマットします。"""
    before_pages_str = ", ".join(map(str, before_pages))
    after_pages_str = ", ".join(map(str, after_pages))

    base_info = {
        "改定後": after_text,
        "改定前": before_text,
        "改定後ページ": after_pages_str,
        "改定前ページ": before_pages_str
    }

    if not client or not AZURE_OPENAI_DEPLOYMENT_NAME:
        return {**base_info, "備考欄": diff_type, "AIによる変更内容の要約": "AIクライアントが初期化されていません。"}

    if diff_type == 'replace': remark = "変更"
    elif diff_type == 'insert': remark = "追加"
    elif diff_type == 'delete': remark = "削除"
    else: remark = diff_type

    prompt = f"""
# 指示
以下の「変更前のテキスト」と「変更後のテキスト」の差分を分析し、変更内容の簡潔な要約を提供してください。
出力は単一の有効なJSONオブジェクトでなければなりません。

# 分析対象テキスト
- 変更前のテキスト: "{before_text}"
- 変更後のテキスト: "{after_text}"

# JSON出力フォーマット
{{ "AIによる変更内容の要約": "ここに簡潔な変更内容の要約を記述してください。" }}
"""
    try:
        response = client.chat.completions.create(
            model=AZURE_OPENAI_DEPLOYMENT_NAME,
            messages=[{"role": "user", "content": prompt}],
            # gpt-4.1を使うなら以下をコメントアウト解除
            # temperature=0,
            response_format={"type": "json_object"}
        )
        content = response.choices[0].message.content.strip()
        cleaned_content = clean_response_content(content)
        ai_summary = json.loads(cleaned_content)
        return {**base_info, "備考欄": remark, **ai_summary}
    except Exception as e:
        print(f"[エラー] 差分のAI要約の取得または解析に失敗しました: {e}")
        return {**base_info, "備考欄": remark, "AIによる変更内容の要約": f"AI要約に失敗しました。エラー: {e}"}

def generate_excel_report(report_data: list, xlsx_path: Path):
    """最終的なレポートデータを、セルを左寄せに設定したExcelファイルに変換します。"""
    xlsx_path.parent.mkdir(parents=True, exist_ok=True)

    wb = Workbook()
    ws = wb.active
    ws.title = "差分レポート"

    header = ["改定後", "改定前", "備考欄", "改定後ページ", "改定前ページ", "AIによる変更内容の要約"]
    ws.append(header)

    for item in report_data:
        ws.append([
            item.get("改定後", ""), item.get("改定前", ""), item.get("備考欄", ""),
            item.get("改定後ページ", ""), item.get("改定前ページ", ""), item.get("AIによる変更内容の要約", "")
        ])

    alignment_style = Alignment(horizontal='left', vertical='top', wrap_text=True)
    for row in ws.iter_rows():
        for cell in row:
            cell.alignment = alignment_style

    for column_cells in ws.columns:
        max_length = 0
        column_letter = column_cells[0].column_letter
        for cell in column_cells:
            if cell.value:
                cell_len = sum(2 if unicodedata.east_asian_width(c) in 'FWA' else 1 for c in str(cell.value))
                if cell_len > max_length: max_length = cell_len
        adjusted_width = min(max_length + 2, 80)
        ws.column_dimensions[column_letter].width = adjusted_width

    wb.save(xlsx_path)
    print(f"左寄せに整形したExcelレポートを保存しました -> {xlsx_path}")

def main():
    if not client:
        print("OpenAIクライアントが初期化されていないため、処理を終了します。")
        return

    input_json_path = Path("output/diff/summary_diffs.json")
    if not input_json_path.exists():
        print(f"入力ファイルが見つかりません: {input_json_path}")
        print("先に `create_diff_highlights.py` を実行してください。")
        return

    with open(input_json_path, 'r', encoding='utf-8') as f:
        diff_summary = json.load(f)

    if not diff_summary:
        print("\n--- 差分は見つかりませんでした。レポート生成をスキップします。 ---")
        return

    print("\n--- 開始: 各差分のAI要約を生成します ---")
    final_report_data = []
    for i, diff_item in enumerate(diff_summary):
        print(f"  > 差分 {i+1}/{len(diff_summary)} を要約中...")
        summary_dict = summarize_difference_with_ai(
            before_text=diff_item["before_text"], after_text=diff_item["after_text"],
            diff_type=diff_item["type"], before_pages=diff_item.get("before_pages", []),
            after_pages=diff_item.get("after_pages", [])
        )
        final_report_data.append(summary_dict)
    print("--- 完了: AI要約 ---\n")

    output_dir = Path("output/diff")
    report_json_path = output_dir / "diff_report.json"
    report_xlsx_path = Path("output/final/diff_report.xlsx")

    with open(report_json_path, "w", encoding="utf-8") as f:
        json.dump(final_report_data, f, ensure_ascii=False, indent=2)
    print(f"AI要約済み最終レポート(JSON)を保存しました -> {report_json_path}")

    generate_excel_report(final_report_data, report_xlsx_path)

if __name__ == "__main__":
    main()
5. ハイライト画像を連結してpdfとして出力(concatenate_images.py)
この処理では、前工程で生成されたページごとのハイライト画像を結合し、1つのPDFとしてまとめて出力します。比較対象である「before」「after」それぞれについて、ハイライト画像をページ順に並べ、統合したPDFを生成します。
・concatenate_images.py
from PIL import Image
from pathlib import Path
import shutil

def create_pdf_from_images(doc_type, input_dir, output_dir):
    """指定されたタイプの画像リストから1つのPDFを作成する"""
    input_dir = Path(input_dir)
    output_dir = Path(output_dir)
    output_dir.mkdir(exist_ok=True, parents=True)

    image_paths = sorted(
        input_dir.glob(f"*_{doc_type}_highlight.jpg"),
        key=lambda p: int(p.stem.split('_')[1])
    )

    if not image_paths:
        print(f"[{doc_type.upper()}] PDFに変換する画像が見つかりませんでした。")
        return

    print(f"[{doc_type.upper()}] {len(image_paths)}枚の画像からPDFを作成します...")

    images = [Image.open(p) for p in image_paths]

    first_image = images[0]
    other_images = images[1:]

    output_path = output_dir / f"final_comparison_{doc_type}.pdf"

    first_image.save(
        output_path,
        "PDF",
        resolution=100.0,
        save_all=True,
        append_images=other_images
    )

    print(f"-> PDFを {output_path} に保存しました。")

    for img in images:
        img.close()

def main():
    input_dir = Path("output/diff")
    output_dir = Path("output/final")
    output_dir.mkdir(parents=True, exist_ok=True)

    create_pdf_from_images("before", input_dir, output_dir)
    create_pdf_from_images("after", input_dir, output_dir)

if __name__ == "__main__":
    main()
出力結果
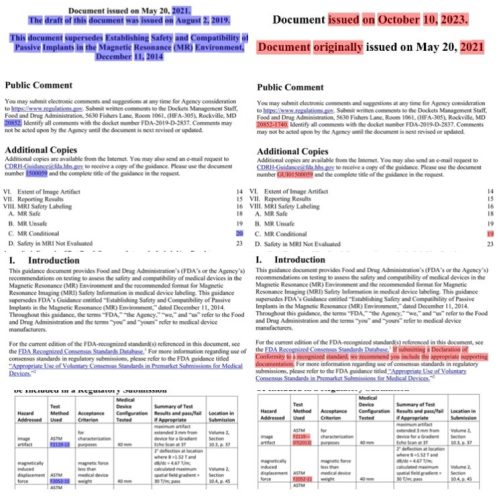
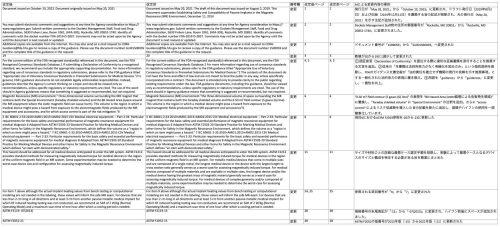
新プロセスによって生成されたハイライト済みPDFと新旧対照表のサンプルです。変更箇所が一目瞭然になっているのが分かります。
コスト比較
今回のプロセス改善によるコスト削減効果を比較しました。(OCR費用は同等なためLLM部分のみで比較)
・旧プロセス (GPT-4.1)
・推定コスト: $0.1914 USD (約28.9円)
・入力トークン: 40,938
・出力トークン: 12,337
・新プロセス (o4-mini)
・推定コスト: $0.0775 USD (約11.7円)
・入力トークン: 8,182
・出力トークン: 15,577
モデル変更による理論上の削減率(45%)を大幅に上回り、最終的にコストを約58%も削減できました。これは、処理フローを「全体比較」に変えたことで、LLMへの入力する文量が効率化され、無駄なトークン消費を抑えられたためだと考えています。
今後の展望
本プロジェクトにより、ページまたぎ比較への対応とコスト削減という2大目標を達成できました。今後は、ツールとしての完成度をさらに高めるため、以下のアップデートを計画しています。
・入力ファイル名の制限撤廃(before.pdf / after.pdf以外の名前も許容)
・さらなる処理速度の向上
今後も、より便利で高性能なAIツールの開発に取り組んでいきます。


