
こんにちは、AI Labの新宮です。
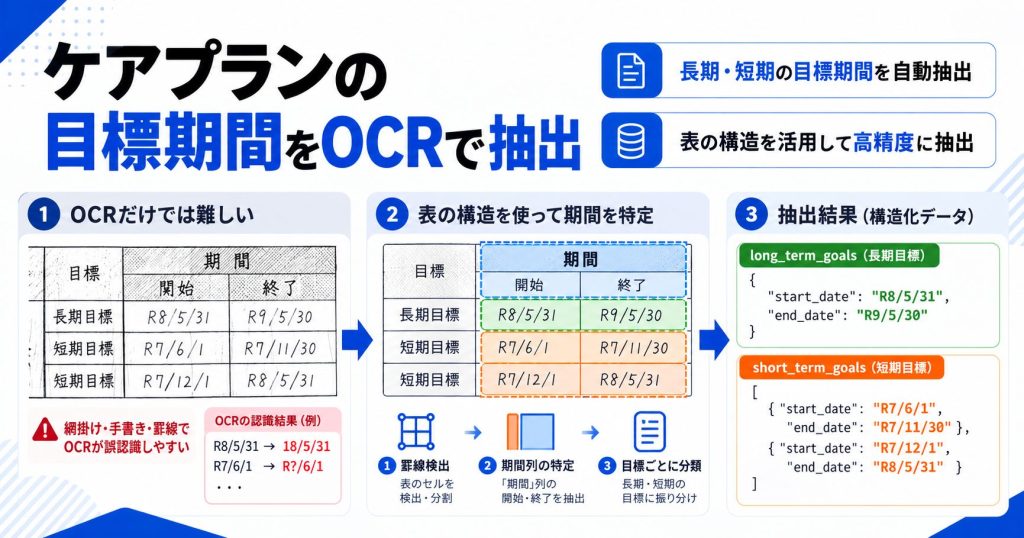
これまでの実装では、居宅サービス計画書(第2表)の期間を書類1件につき「最も早い開始日〜最も遅い終了日」の1組に集約していたため、目標ごとの期間を取得できず、期限管理(有効期限アラート)の元データとして使えない状態でした。
今回は、第2表に記載される長期目標・短期目標の期間を、OCRの結果から目標ごとに抽出する処理を実装しました。本記事では、試したアプローチの変遷と、最終的な実装で工夫した点を紹介します。
▼ 課題
網掛けやFAXの劣化がある書類では、OCRの結果に次のような問題がありました。
- 網掛けされた「期間」の見出しが読めない、または「期蘭」のように誤読される
R8/5/31のRが1と読まれて令和18年になるなど、元号が数字に化ける- 日付に接した縦罫線が数字の
1として読まれ、12026/03/01のような5桁の年になる - 1つの期間が
R7/2/1~とR8/1/31の2行に分かれて書かれている - 作成年月日や、サービス内容側の「期間」列など、目標の期間ではない日付が同じページにある
▼ 今回の目標
- 長期目標・短期目標の期間を、目標ごとに開始日・終了日の組で取得する
- 開始日・終了日が記載されていない、または判定できない場合は
nullを返す
▼ 結果
罫線を検出して表をセルに分割し、1セル=1目標の期間として読む方式を実装し、既存のPDF処理パイプラインに組み込みました。セルの中で開始日・終了日を判定するため、片方がOCRで欠けても、その影響が他の目標の期間に及ばない構造になっています。また、探索範囲を表の枠内に限定し、作成年月日のような表の外の日付を対象から外しています。
アプローチの変遷
「期間」見出しを起点にする方式
最初に、「期間」の見出しを探してその下の日付を拾う方式を検証しました。検証した100枚のうち、長期・短期の「期間」が両方とも認識できたのは95枚でした。見出しが読めないと、日付が読めていても抽出できません。
日付の位置だけで列を作る方式
次に、見出しを使わず、日付の文字列をx座標でまとめて列を作る方式を実装しました。左から1本目を長期目標、2本目を短期目標の期間列とし、列内を上から 開始・終了・開始・終了… と組にします。
見出しが読めなくても抽出できるようになった一方で、次の問題が残りました。
- 開始日か終了日の片方が欠けると、以降の組がすべて1つずつずれる
- 作成年月日やサービス内容側の期間列を、目標の期間列と取り違える
罫線でセルに分割する方式
最終的には、表の罫線を画像から検出してセルに分割し、セル単位で期間を読む方式にしました。罫線が取れないページだけ、日付の位置で列を作る方式にフォールバックします。
罫線によるセル分割
罫線はOpenCVのモルフォロジー演算で抽出します。二値化した画像に対し、軸方向に長いカーネルで開演算をかけ、長く連続する画素だけを罫線として残します。
工夫した点は次の3つです。
- 「(期間)」欄の網掛けが塗りつぶしごと罫線として拾われないよう、二値化の前に中間グレーを白に飛ばす
- 破線の隙間を埋める幅を縦方向では小さくし、隣のセルの文字が繋がって偽の縦罫線になるのを防ぐ
- 線として太すぎる部分を画素単位で取り除き、文字が密集した箇所を罫線と誤認しない
検出したセルには行番号・列番号を付け、OCRの各 word の中心座標(インチ)をピクセルに変換して、中心を含むセルへテキストを割り当てます。
探索するのは、ページで枠が最も大きい表(=第2表の本体)の中だけです。作成年月日欄やFAXヘッダの日付は、この時点で対象から外れます。
期間列を長期・短期に振り分ける
日付と 〜 がセルの文字の大半を占めるセルを期間セルとし、列ごとにまとめます。
期間列の見出しは「(期間)」だけのことが多いため、期間列から左へ目標の見出しを探し、最初に見つかった「長期目標」「短期目標」の側に振り分けます。
見出しのOCR結果には「短期自杯」「長期日標」のような崩れがありました。文字列の類似度で照合すると、先頭1文字しか違わない「長期目標」と「短期目標」を取り違えてしまいます。そこで、先頭の「長」「短」だけは完全一致を求め、崩れやすい後半は「期」を含むかだけを確認しています。
def classify_goal_label_loosely(content: str | None) -> GoalPeriodLabel | None:
    normalized = normalize_base(content)
    if normalized is None:
        return None
    compact = remove_whitespace(normalized)
    exact = _LABELS.get(compact)
    if exact is not None:
        return exact
    if len(compact) > MAX_GOAL_LABEL_CHARS or "期" not in compact:
        return None
    return _GOAL_HEAD_LABELS.get(compact[0])  # "長" / "短"
見出しが1つも読めないページでは、表の並び(左が長期・右が短期)で振り分けます。
セル単位で開始日・終了日を読む
1セルのテキストから、次のルールで期間を読みます。
| セル内の日付 | 判定 |
|---|---|
| 2つ以上 | 最初を開始日、最後を終了日 |
1つで、後ろに 〜 がある | 開始日 |
1つで、前に 〜 がある | 終了日 |
1つで、〜 が読めない | 開始日(終了日は null) |
OCRの誤読で暦としては成立する値になる場合に備え、次の対策も入れました。
- 実行時の年から大きく離れた年の日付は採用しない
- 同じセルの別の日付に元号が付いていて、元号の無い2桁年の日付が範囲外のときは、先頭1桁を元号の誤読とみなして読み直す
- 5桁の年は、先頭1桁(罫線由来の
1)を落とした年が妥当な範囲に収まるときだけ読み直す - 罫線の誤検出で上下に割れた2行の期間セルは、セルの高さと位置関係から判断して1つにまとめる
列の総意で欠けた日付を補う
正解データを確認すると、同じ期間が列内で繰り返されることが多く(97列中85列)、長期目標と短期目標の開始日も共通することが多い(46件中37件)とわかりました。この性質を使って、読めなかった日付を補います。
def _column_consensus(values: Iterable[str | None]) -> str | None:
    """列内で読めた値の最頻値。2 件以上かつ過半数を占めるときだけ返す。"""
    known = [value for value in values if value]
    if len(known) < 2:
        return None
    value, count = Counter(known).most_common(1)[0]
    return value if count * 2 > len(known) else None
まず列ごとに、読めなかった開始日・終了日を列の総意で補います。それでも埋まらない開始日は、もう一方の列の総意で補います。長期と短期は期間の長さが違うのが普通なので、列をまたいで補うのは開始日だけです。読めた値は書き換えません。
正解データによる評価
どのアルゴリズムがよいかを判断するため、PDFを目視で確認して正解データを作り、抽出結果と自動で突き合わせるスクリプトを作成しました。誤りは「値があるのに null にした」「別の値を出した」「無い値をでっち上げた」に分けて集計しています。
セル単位の判定を導入した初期段階の評価結果は次のとおりです。
| 指標 | 結果 |
|---|---|
| 列のセル数一致 | 67/97(69.1%) |
| セル完全一致 | 255/374(68.2%) |
| 項目一致(開始日・終了日を別々に数える) | 545/748(72.9%) |
その後、罫線によるセル分割と振り分けを実装し、改善を進めました。たとえば、割れたセルをまとめる処理を、もう一方の列の件数を目安にする方式からセルの形で判断する方式に変えたところ、サンプル49件(期間列99列)で正解と一致する列が97列から99列になりました。
まとめ
今回は、居宅サービス計画書(第2表)の長期目標・短期目標の期間を、目標ごとに抽出する処理を実装しました。罫線でセルに分割して1セル=1目標の期間として読むことで、日付の欠落による組のずれや、表の外の日付の誤取得が起きにくい構造にしました。
一方で、OCRの結果によっては、まだ正しく取れない書類もあります。また、現時点では抽出結果をDBに保存していません。人の目でも読めない日付への対応として、読めない箇所を null にし、ユーザーに修正してもらうような仕組みも必要だと考えています。


