
こんにちは、AI Labの新宮 尊です。
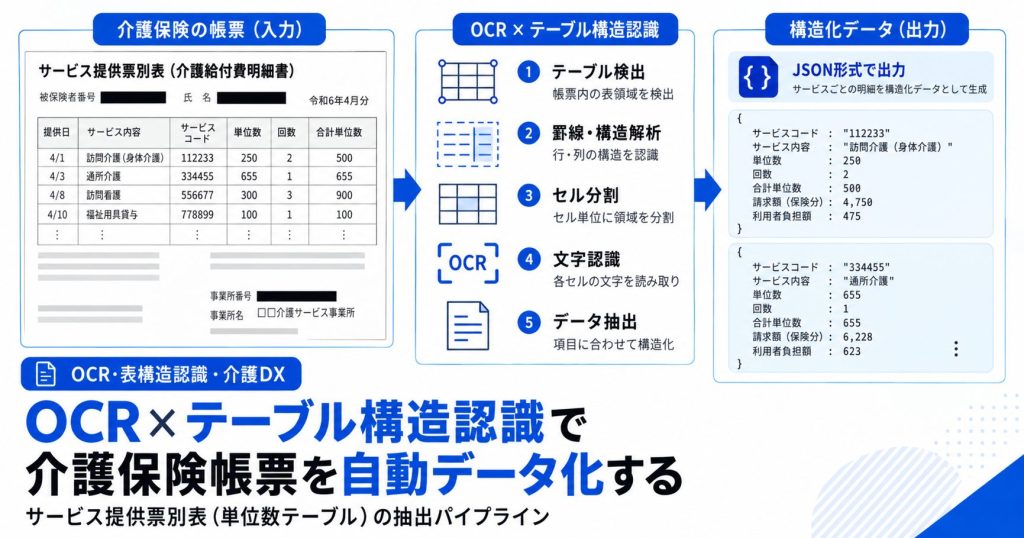
今回は「AI福祉書類管理」サービスの新機能として開発した、介護保険の月次帳票「サービス提供票別表(単位数テーブル)」をPDFや画像から自動抽出し、構造化データとして取り出す仕組みについて紹介します。
この帳票には、事業所名・サービスコード・単位数・回数・費用総額・保険給付額・利用者負担額といった項目が、複雑な罫線構造の表にびっしりと詰め込まれています。担当者が帳票を目で確認しながら1件ずつ転記していく作業は、件数が多い事業所ほど負担が大きくなります。これを自動でJSON化できれば、月末の転記作業や実績集計にかかる工数を大幅に削減できます。
開発のポイントは、単純にOCRへ画像を投げるだけでは正しい表データが得られないという点でした。罫線が二重になっていたりセルが結合されていたりする、個人情報保護のため氏名欄が黒塗りされている、1ページに複数の表が並んでいる、見出しが2段組みで表記ゆれもある、といった帳票特有の癖が強く、罫線検出・セル構造の復元・OCR・見出し照合・構造化変換を組み合わせたパイプラインとして設計する必要がありました。
開発環境
- 言語: Python
- 画像処理: OpenCV(cv2)による二値化・罫線検出・モルフォロジー演算
- OCR: Azureの光学文字認識サービス(単語単位でテキストと座標を取得)
- 抽出補助: 対象月・利用者名などをLLMによる抽出ステップで補完
- 実行基盤: Docker / Docker Composeのworkerコンテナ
- 品質管理: pre-commit、ruff、mypy、pytest
- ソース管理: GitHub(PRベースのレビュー運用)
帳票内の数値は金額や単位数に直結し、1文字の誤読が大きな影響を及ぼします。そのため、精度の読みにくいディープラーニングの表構造認識モデルに丸ごと頼るのではなく、「セルの境界を正確に検出し、そこにOCR結果を割り当てる」ロジックベースの設計を優先しました。実行基盤にDockerを採用したのは、OpenCVやOCR用SDKなど環境依存のライブラリが多く、誰の手元でも同じ結果が再現できる環境をコード化しておきたかったためです。
環境構築
開発・検証はすべてDockerコンテナ上で完結させています。罫線検出の中間結果(二値化後の画像や検出したセルの矩形)を画像として出力できるようにし、環境変数でデバッグ出力の有無を切り替えられるようにしました。本番ではオフにすることで余計なI/Oを防いでいます。
デバッグモードを有効にすると、検出したセルの境界を元画像に重ねて描画した画像が作業ディレクトリに書き出されるようにしており、精度調査のたびにログの数値だけを見て推測するのではなく、実際の画像を見ながら原因を特定できるようにしていました。コンテナ内のデバッグ画像や中間JSONは、以下のようなコマンドでローカルに取得して確認していました。
docker compose cp worker:/tmp/debug ./debug
コミット前にはpre-commitフックで静的解析・フォーマットチェックを実行しています。
pre-commit run --all-files
メイン処理のスクリプトと開発フロー
1. 既存資産の移植とパイプライン基盤構築
過去のプロジェクトで作成した罫線検出のロジックを移植するところから着手しました。帳票のタイトル文字列である程度処理を分岐できるため、タイトルを見て適用するステップを切り替える設計にし、PDF/画像の読み込みからJSON出力までを一気通貫でつなぐパイプラインの基盤を構築しました。
セルの行・列情報は、当初は中心座標のクラスタリングで求めていましたが、結合セルで不整合が発覚したため、HTMLのtable要素に近い「セルの境界情報+rowspan・colspan相当のspan情報」を持つモデルに再設計しています。また、1ページに複数の独立した表が並ぶ帳票もあったため、検出した表同士のバウンディングボックスが一定以上重なっている場合は同一の表とみなして統合するロジックも追加しました。
2. 罫線検知の精度向上とノイズ対策
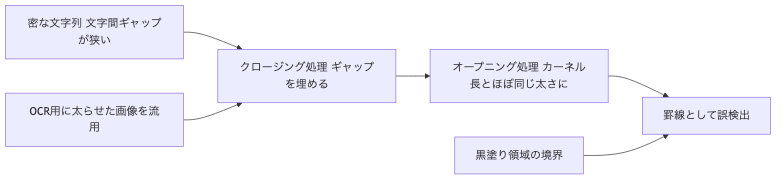
罫線検出は後続処理すべての土台になるため、最も時間をかけて改善したポイントです。罫線検出の処理は、画像を二値化したあとに隙間を埋めるクロージングと、細い線だけを残すオープニングを組み合わせています。調査の結果、文字間隔が狭い密な文字列がクロージング処理で連結され、オープニング処理を通過できる太さの「線」として誤って残ってしまうことが根本原因だと分かりました。入力画像をA4横相当の解像度に固定でリサイズしていたため、そのサイズでの文字幅とオープニングのカーネル長がほぼ一致してしまっていたことも誤検出を助長していました。さらに、OCR用に文字を太らせた画像を罫線検出にもそのまま流用していたため誤検出が悪化しており(誤検出画素がおよそ2倍)、黒塗り領域も適応的二値化の特性上、境界だけが前景化して疑似的な罫線を生んでいました。この仕組みを整理すると、以下のような流れで誤検出が発生していました。
原因の一つは、二値化処理のパラメータの符号ミスでした。
cv2.adaptiveThreshold(
    gray_image, 255,
    cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
    cv2.THRESH_BINARY_INV,
    blockSize=25,
    C=2,  # 符号を誤って -2 としていたためノイズが増えていた
)
このパラメータ修正と、二値化処理を独立した関数として切り出すリファクタリングにより、罫線検出の精度は大きく改善しました。
3. セル構造・見出し照合のブラッシュアップ
罫線精度を上げたあとも、面積フィルタによる境界情報の消失やクラスタリングでの誤融合など複合的な要因で、一部のセルが認識されない問題が残っていました。デバッグ画像で検出結果を可視化しながら、一つずつ原因を切り分けて調整しています。
見出し照合では、OCRで読み取った文字列と項目名候補を長い文字列から前方一致で照合する方式を採用しました。候補を文字数の長い順に並べてから判定することで、「単位数」のような短い項目名が「単位数単価」のような長い項目名の一部にたまたま一致してしまう、部分一致の誤りを避けています。表記ゆれは正規化で、2段組みの見出しは列単位で縦連結してから照合しています。ただし、あいまい一致を緩めすぎると2文字程度しか違わない項目同士を誤マッチすることがあったため、紛らわしい語を「マッチさせてはいけない語」として登録し、安全側に倒しました。この改善により、検証用128ページのうち見出しが1列も読めず処理を断念していたページを40ページから27ページまで減らせています。
4. OCR結果のセル割り当てと構造化JSON
OCR結果は単語単位で返ってくるため、各単語のバウンディングボックスがどのセルに含まれるかを判定して割り当てています。単語同士を単純に連結すると「1884」と「90」が「188490」になってしまうような数値破壊が起きるため、半角英数字同士が隣接する場合にのみスペースを挿入するルールを追加しました。
見出しとセルの対応が取れたら、行ごとにデータを組み立てて構造化JSONを出力します。対象月・利用者名は表構造だけでは判定しづらいため、上流のLLM抽出ステップの結果を統合しています。検証データの多くが黒塗りされたものだったため、明細行判定に使う事業所名の列が空になり行ごと消えてしまう事象も見つかり、黒塗りなしデータでの再検証が今後の課題として残っています。
5. テストとレビュー対応
罫線検出・セル構造復元・見出し照合・JSON出力のそれぞれにテストコードを追加しました。レビュー運用も見直し、レビューに回す前に実装担当者自身で以下をチェックする運用ルールを導入しています。
・デッドコードの有無
・import文の場所(できるだけ文頭に)
・パイプラインで実行する関数がモジュール化されているか
・pre-commit run --all-files を実行してテスト失敗がないこと
・入れたコードのせいでパフォーマンスが落ちていないこと
・作った処理がすでにあるコードと重複していないこと
・コードが綺麗にまとまっていること
・デバッグ出力をoffにする
このチェックを終えた段階でレビュー担当に引き継ぐようにしたことで、実装内容の手戻りを減らせました。
最終的なスクリプトや動作解説
パイプラインは、大きく以下のステップで構成されています。
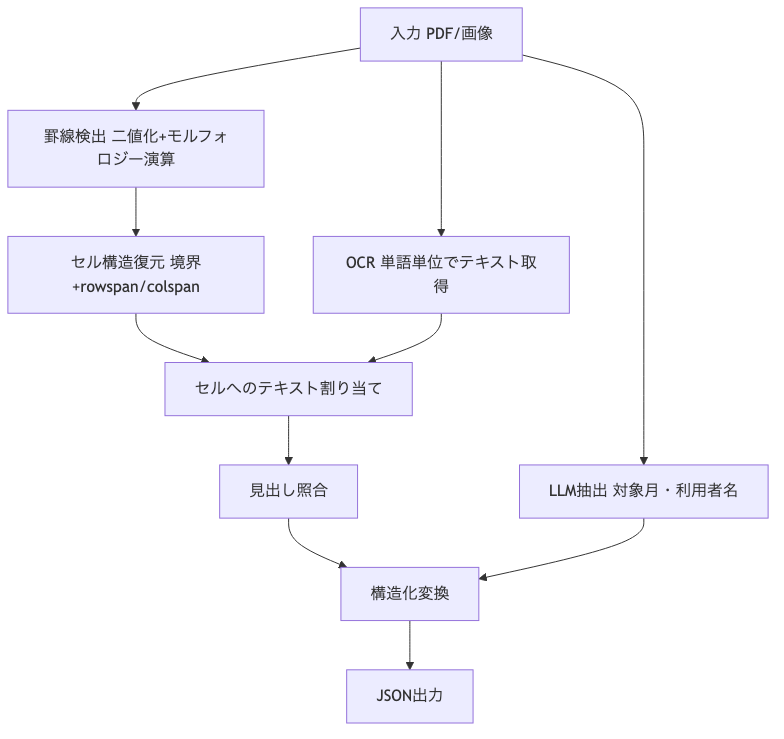
各ステップは独立したモジュールとして実装しているため、帳票フォーマットが増えた場合でも対応が必要なステップだけを差し替えられます。最終的な出力JSONのイメージは以下の通りです(値は説明用のサンプルです)。
{
  "target_month": "2024-07",
  "client_name": "サンプル 太郎",
  "rows": [
    {
      "provider_name": "サンプル訪問看護ステーション",
      "provider_number": "0000000000",
      "service_code": "131111",
      "service_name": "訪看I2",
      "unit_score": 471,
      "count": 5,
      "total_units": 2355,
      "insurance_claim_amount": 22678,
      "copayment_amount": 2520
    }
  ]
}
rows配列の各要素がサービス提供票別表の明細行1件分に対応しており、帳票上のレイアウトに関わらず一貫したキーで取得できるため、後続の請求チェックや実績集計にそのまま利用できます。
今後の展望
黒塗りされた検証用データをもとに開発を進めてきたため、黒塗りされていない実データでの精度検証が今後の課題です。特に明細行の判定や利用者名の抽出は黒塗り領域の影響を強く受ける部分のため、実データでの挙動を改めて確認していく必要があります。また、対応する帳票フォーマットが増えるにつれてルールも複雑になっていくため、表構造認識にディープラーニングを部分的に取り入れることも選択肢として検討しつつ、精度と保守性のバランスを見ながら改善を続けていきたいと考えています。
今回開発したノウハウは他の介護保険関連帳票にも応用できる部分が多く、今後は対象帳票の種類を広げながら「AI福祉書類管理」サービス全体の自動化範囲を拡大していく予定です。


