
こんにちは、AI Labの石川晴です。
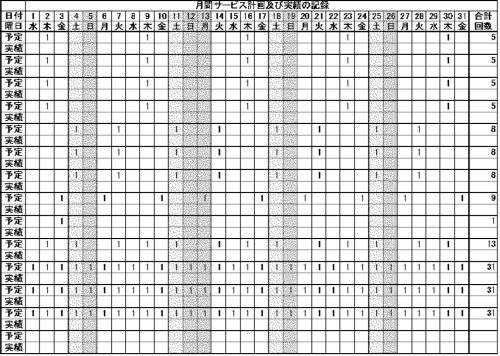
介護保険の請求業務では、サービス提供票という帳票が毎月やり取りされます。 利用者ごとに1枚、日付1〜31日の列とサービスごとの予定/実績の行が交差するマス目があり、サービスを提供した日のマスに、その日の提供回数が書き込まれています。
このマスの数字を読み取ってデータ化できれば、実績の集計や他システムとの突合が自動化できます。
クラウドの高性能なOCRに投げれば済む話に思えました。 ところが、Azure Document Intelligence Readモデル(以下 DI)にページを読ませると、サービス名やヘッダの印字はきれいに取れる一方で、マス内の数字は取りこぼしたり、罫線のかすれと混ざった文字列で返ってきたりします。 マスが小さく、線が細く、しかも土日や祝日の列には網掛け(あみあみの背景模様)が印刷されているためです。
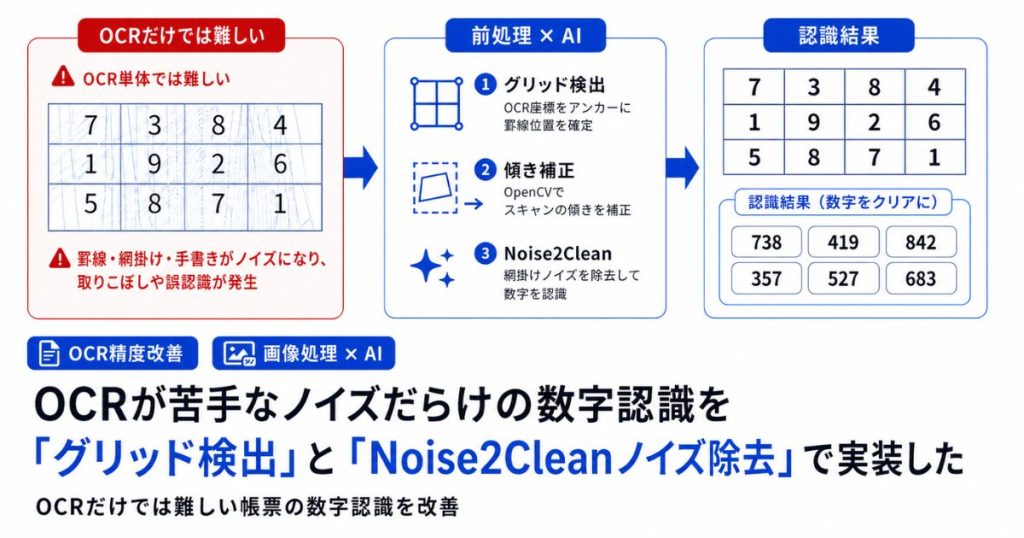
そこで私たちは、DIとは別のチャネルとして、罫線からマス目の位置を確定するグリッド検出と、網掛けをノイズ除去モデルで消してから小さな画像認識モデルで数字を読むNoise2Cleanベースの数字認識を組み合わせた自前パイプラインを開発しました。 この記事では、この2つの技術を中心に、開発の流れと途中でぶつかった課題を解説します。
開発環境
今回の開発では、画像処理とAIモデルの連携を中心に、次のリソースと技術スタックを使用しました。
- 言語: Python
- 深層学習フレームワーク: PyTorch(数字分類モデルとデノイザーの学習・推論に使用。本番の推論はCPUのみで動作)
- 画像処理ライブラリ: OpenCV、NumPy(罫線の検出、傾きの推定、マスの切り出しに使用)
- PDFレンダリング: PyMuPDF(PDFのページを画像に変換)
- OCRサービス: Azure Document Intelligence Readモデル(上流の処理で取得済みの結果を再利用)
罫線の検出や傾きの補正はOpenCVによる自前処理で行い、位置の手がかりが必要な部分にはAzureのOCR結果を組み合わせるハイブリッドな構成を採用しました。
環境構築
このシステムは単体のスクリプトではなく、既存の書類処理パイプラインの1ステップとして動きます。 デプロイもバックエンド全体のリリースフローに乗るだけなので、機能固有の手順は依存パッケージの追加と学習済みモデルファイルの配置に集約されます。
学習済みモデルは2つあり、どちらもチェックポイント(学習済みの重みを保存したファイル)をコードと同じリポジトリに同梱して起動時に読み込みます。 数字分類用のモデルと、網掛け除去用のデノイザーです。 デノイザーは「チェックポイントが存在すれば使う」設計にしてあり、モデル差し替えの実験がファイルの入れ替えだけでできます。
処理の全体像
処理は大きく「グリッド検出でマス目の境界を確定する前半」と「各マスを切り出して数字を読む後半」に分かれます。 以下、それぞれについて「直面した問題」と「どの処理が解決したか」を見ていきます。
フェーズ1: OCRの座標をアンカーにしたグリッドの仮説づくり
最初に考えたのは、罫線だけからグリッドを検出する方法でした。 表なのだから、縦横の直線を検出して交点を取れば終わるはずです。 ところが実際のスキャン画像では、手書きの線や印字の下線が罫線候補に混ざり、かすれた罫線は途切れて検出されず、候補線の取捨選択が泥沼になりました。
発想を変えて、DIの読み取り結果を位置の手がかりに使うことにしました。 DIは手書き数字こそ苦手ですが、印字された日付ヘッダ「1〜31」と行ラベル「予定/実績」はかなり正確に読みます。 このx座標とy座標をアンカー(位置決めの基準点)として、列と行の中心位置の仮説を立てるのです。 DIが数字をいくつか読み落としてもよいように、取れた中心位置に等間隔の格子を最小二乗法でフィットし、欠けた列や行は格子の側から補完します。
フェーズ2: 罫線プロファイルへの吸着
アンカーから作った格子は、あくまで文字の位置から推定した仮説です。 文字はマスの中心に印字されているとは限らず、実際の罫線とは数ピクセルずれます。 マスを切り出したときに罫線がマス内へ入り込むと、後段の数字認識が罫線の断片を「1」と誤読するので、このずれは放置できません。
そこで、格子を実際の罫線へ吸着させる工程を2段階で入れました。
まず、画像から罫線らしさの1次元プロファイルを作ります。 画像を白と黒の2色だけに変換(二値化)し、各x位置(縦線用)または各y位置(横線用)について、±1ピクセルの帯にインクがある画素の割合を計算したものです。 ページの上下いっぱいに連続する罫線は高い値になり、局所的な手書きは平均化されて低い値になります。
1段階目は櫛(くし)の一括フィットです。 31本の縦境界線を等間隔の櫛とみなし、櫛全体の平行移動と伸縮を総当たりで振って、プロファイルとの相互相関(罫線の山との重なり具合を表すスコア)が最大になる位置を探します。
def fit_comb(lines, profile, max_shift=18, max_scale=0.03, n_scale=13):
    lines = np.asarray(lines, dtype=float)
    c = lines.mean()
    best = (0.0, 1.0, -1.0)
    for sc in np.linspace(1 - max_scale, 1 + max_scale, n_scale):
        for sh in range(-max_shift, max_shift + 1):
            pos = c + sc * (lines - c) + sh
            idx = np.clip(pos.round().astype(int), 0, len(profile) - 1)
            score = profile[idx].sum()
            if score > best[2]:
                best = (sh, sc, score)
    sh, sc, _ = best
    return c + sc * (lines - c) + sh
全部の線をまとめて動かすのがポイントです。 線を1本ずつ最寄りの山へ動かすと、手書きの縦棒に釣られて1本だけ明後日の方向へ飛びますが、櫛ごと動かせば31本の合議になるので、局所ノイズに引きずられません。
2段階目は個別の微調整です。 一括フィット後の各線を、線の間隔の±20%という狭い窓の中でだけ、プロファイルの近くの山へ動かします。 窓の外へは出られないので隣の線や手書きへ飛ぶことはなく、窓内に十分な罫線がなければ一括フィットの位置をそのまま維持します。 「全体で合わせてから、逃げられない範囲で個別に合わせる」という2段構えで、印刷のわずかな不等間隔まで吸収できるようになりました。
フェーズ3: OpenCVによる傾き補正
ここまでで、まっすぐスキャンされたページはほぼ正しく検出できるようになりました。 うまくいっているに違いないと思いながら実データを流し続けると、特定のページ群だけマスの下段がずれていきます。 原因はスキャン時の傾きでした。 ページ全体が1〜2度回転していると、等間隔格子も罫線プロファイルも「画像の縦横に平行な線」を前提にしているため、ページの端へ行くほど誤差が積もります。
対策として、グリッド検出を傾き推定を挟んだ2パスにしました。
- まず素の画像でグリッドを検出する(多少ずれていても外枠の位置は取れる)
- グリッド外枠付近の領域にOpenCVの直線検出機能(
HoughLinesP)をかけ、ほぼ水平な線分の角度の中央値をskew角(スキャン時に生じた微小な傾きの角度)とする - 角度が0.2度以上なら、画像とOCRアンカー座標を同じ回転行列で回してから、グリッドを検出し直す
角度を1本の線分ではなく多数の線分の中央値から取るのは、手書きの横線や印字の下線が混ざっても、多数派である罫線の角度が勝つようにするためです。 また、0.2度未満を補正しないのは、その程度の角度は推定誤差と区別がつかず、回転で画像を作り直すときの画質劣化で細い手書き線を潰す損のほうが大きいからです。 「検出してみて、傾いていたら回して取り直す」という素朴な2パス構成ですが、傾き推定に必要な外枠の位置は1パス目のグリッド検出が教えてくれるので、専用の傾き検出処理を別に作るより単純に済みました。
フェーズ4: Noise2Cleanデノイザーの学習
グリッド境界が確定したら、罫線の太さと傾きに沿った透視変換(斜めに歪んだ四角形をまっすぐな長方形へ引き伸ばす変換)で各マスを切り出し、空マスや罫線の消し残りなど「数字でないマス」を前処理と棄却判定で除いてから、数字認識へ進みます。 この掃除と棄却をどれだけ磨いても、どうにもならない敵が残りました。 網掛けです。 土日や祝日の列には、あみあみの背景模様が印刷されており、その上に数字が書かれているマスがあります。以下は二値化した網掛けマスの画像です。
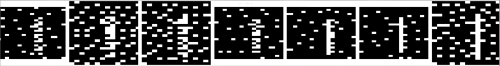
古典的な画像処理で網点を消そうとすると、細い手書き線まで一緒に消えます。 消し方を弱めれば網点が残ってモデルが誤読します。 モルフォロジー演算(線を太らせたり細らせたりする古典的な画像処理)のパラメータをいくら振っても、「網点は消えて数字は残る」点には着地しませんでした。
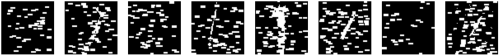
ここで深層学習によるノイズ除去、Noise2Clean方式のデノイザーを導入しました。 Noise2Cleanとは、「ノイズの乗った画像」と「同じ内容のきれいな画像」のペアを大量に見せて、ノイズの消し方そのものをモデルに学習させる方式です。 以下は今回のモデルの学習結果です。1枚目が入力画像、2枚目が教師画像、3枚目が出力画像です。
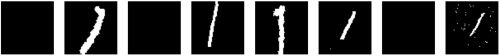
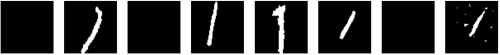
学習ペアがない問題と、合成劣化という解決
方式を決めた直後に、当たり前の壁にぶつかりました。 学習に必要な「同じマスの、網掛けあり画像ときれいな画像のペア」が存在しないのです。 実帳票の網掛けマスから手作業で網点だけを消して正解画像を作る手もありますが、1枚ずつレタッチする工数を考えると数千ペアの規模は現実的ではありません。
そこで発想を逆にしました。 よく知られている方法ですが、きれいな画像にノイズを人工的に合成するのです。 きれいな手書き数字なら、公開の手書き文字データベース(ETL)に大量にあります。 このクリーン画像を正解とし、そこへ実帳票で観察したノイズを再現して乗せた画像を入力とすれば、ペアはいくらでも作れます。 しかも学習中に毎回その場で合成するので、同じ数字画像から毎エポック(学習データ全体を1周する単位)違うノイズパターンが生成され、データ拡張(学習データに変形を加えて実質的な枚数を増やす技法)としても働きます。
合成の質がそのままモデルの質になるので、劣化処理は実際の網掛けマスを拡大して観察するところから設計しました。 観察からわかったのは、網点が「丸い点」ではなく横長の小さな矩形(2×5ピクセル前後)であること、手書き線がスキャンでところどころ掠れること、ペンの太さが枚数ごとにばらつくことです。 これをそのまま3段の劣化として実装しました。
def degrade(clean, rng):
    """クリーンマスク -> 太さジッター -> 掠れ -> 網掛け の順で劣化させた入力。"""
    out = thickness_jitter(clean, rng)   # 線を確率的に太らせ/細らせる
    out = stroke_dropout(out, rng)       # 横長の小矩形60〜120個で線をくり抜く(掠れ)
    out = add_amikake(out, rng)          # 横長の小矩形40〜80個を散布する(網点)
    return out
網点の形状は観察に合わせて2×5、2×6、2×4、3×6ピクセルの4種類を用意し、実際の出現頻度に近い重みでランダムに選びます。 個数や太さの振れ幅も乱数で毎回変えるので、モデルは特定のノイズパターンの暗記ではなく「横長の小さな塊は背景、つながった線は数字」という区別そのものを学ぶことになります。
学習データにはもう1種類、変わったサンプルを混ぜています。 数字なし、網掛けだけの画像を入力とし、真っ黒な画像を正解とする負例で、全体の3割を占めます。 数字入りのペアだけで学習したモデルは、何を入れても数字らしき形を出力しようとする方向へ寄ってしまうため、「数字がなければ何も残さない」という挙動を負例として明示的に教えておくのです。
損失関数: 細い線を欠けさせないために
モデルは、画像を入れると同じサイズの画像を返す構造のニューラルネットワークUNetです。 入力は64×64ピクセルの白黒画像、出力は各画素が「数字のインクである確率」で、学習はこの出力と正解画像の差を損失関数(モデルの誤りの大きさを測る関数。この値が小さくなるよう学習が進む)で測って進めます。
最初に試した素朴なピクセル単位の誤差では、細い数字が痩せる問題が出ました。 64×64のマスのうち、数字のインクはせいぜい数%です。 背景の画素が圧倒的に多いので、モデルは「迷ったら黒」に倒すだけで損失を下げられてしまい、細い「1」の線が途切れがちになります。
対策として、2つの損失を組み合わせました。 1つめはBCE(画素ごとに正解とのずれを測る損失)で、インク画素の間違いを背景画素の4倍重く数え、「迷ったら黒」が損になるよう重み付けします。 2つめはDice損失で、画素単位ではなく「正解のインク領域と予測のインク領域がどれだけ重なっているか」を画像全体で測ります。 インクが数%しかない画像でも、重なり率は数字が欠ければはっきり悪化するので、細い線の欠落に敏感な指標になります。 画素単位のBCEと領域単位のDiceを足すことで、「網掛けは残さず、細い線は欠けさせない」の両立に届きました。

学習そのものは標準的な構成です。 最適化にはAdam(学習の進み幅を自動調整する定番の最適化手法)を使い、データの1割を検証用に取り分けて50エポック回し、検証データでの損失が最良だったエポックの重みを保存します。 学習データではなく検証データの損失で選ぶのは、合成ノイズの暗記ではなく未知のノイズへの汎化を取るためです。 推論は、マス画像を64×64に整えてUNetに入れ、出力の確率を0.5で二値化するだけです。 ただし、白文字/黒背景への統一、数字部分の切り出し、64×64への配置という前処理は、学習時と本番で同じ実装に揃えました。 学習時と違う整え方で入力すると、モデル自体は正しくても出力が崩れるからです。
フェーズ5: CNNによる数字予測
最後に、生き残ったマス画像を数字分類モデルへ渡します。 モデルは畳み込み3層のごく小さなCNN(画像認識で定番のニューラルネットワーク)で、手書き数字の公開データセットで事前学習し、この帳票の実データで1〜5の数字向けに追加学習(ファインチューニング)したものです。
ここでもデノイザーと同じく、精度を左右したのは入力の整え方でした。 学習データと同じ作法で数字を切り出し、28×28の黒キャンバスに数字の重心が中心へ来るよう貼り付けます。 数字を囲む長方形の中心で置くと、「7」や「9」のような重心の偏った数字が学習時の見え方からずれ、判定が不安定になりました。 推論はページ内の全対象マスをまとめてバッチで流すので、CPUでも1ページあたりの処理時間は実用範囲に収まっています。
今後の展望
現時点のパイプラインでは読み取った数字の検算として、1行ずつ読み取った数字の合計と「合計回数」の値が等しくなるかをチェックしています。 合計回数のマスは他の数字マスと大きさが違ったり、2桁の数字があったりすることからOCRで値を読み取っています。 しかし、冒頭で話した通りマス内の数字の読み取り精度は良くありません。今後はこの列の数値も今回のシステムで読み取れるようにしていきます。


