
こんにちは、AI Labの堂上 拓です。
数ヶ月前の記事で書類の押印・サイン検出機能の従来版の実装について紹介しました。
今回はその続きとして、この機能を実務で使える精度まで引き上げたアップデートの技術的な詳細を紹介します。
▼ 課題
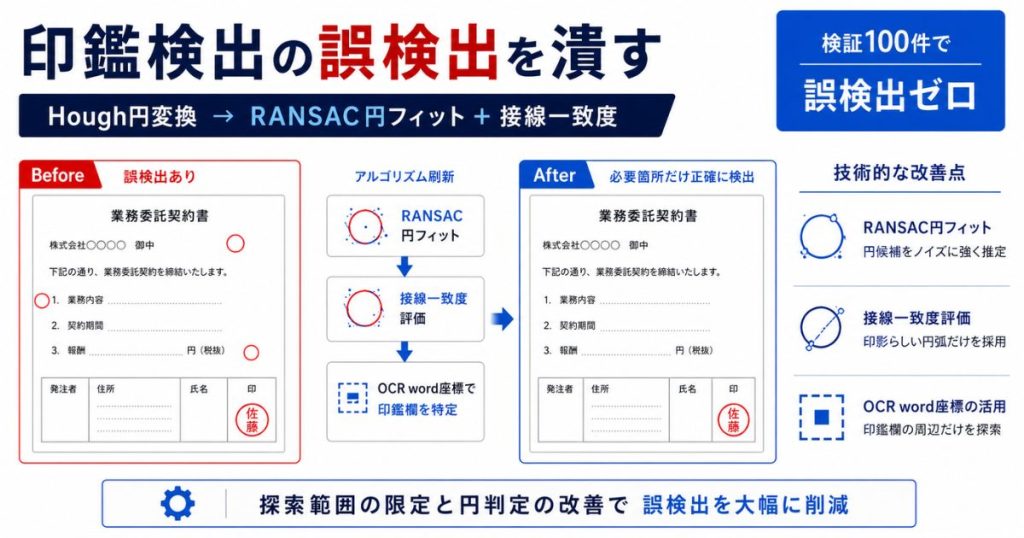
今回もっとも大きな問題が誤検出でした。従来版は、印鑑ではないものを大量に「印鑑」として拾っていました。丸囲み文字、罫線の交差、網掛け模様、本文の文字の集まり。ページ全体から円を探すフォールバック処理があったため、印鑑が1つも押されていないページでも検出結果が並びます。
また、従来版の出力は has_stamp(印鑑が写っているか)というbool値だけでした。「押すべき箇所がいくつあり、そのうち何箇所が押されているか」を数える仕組みがなく、押印もれの判定は原理的に不可能でした。
▼ 今回の目標
「印鑑と言ったら本当に印鑑である」状態をつくり、そのうえで押印もれを数えられるようにすることを目指しました。
押印もれ判定は「印鑑がN個ある」ことを土台に成り立ちます。誤検出が1つ混ざるだけで結論がひっくり返るため、誤検出の削減が押印もれ判定の前提になります。
▼ 結果
円検出をHough変換からRANSACベースの自前実装へ置き換え、探索範囲を押印欄・署名欄の近傍に限定しました。
検証に用いたサンプル100件では、開発時点で誤検出をゼロに抑えられています。出力も、押印必要箇所のうち何箇所が押されているかをログへ出せるようになりました。
目次
この記事で出てくる用語
先に、繰り返し出てくる言葉をまとめておきます。すでにご存知の方は読み飛ばしてください。
| 用語 | 意味 |
|---|---|
| ROI(Region of Interest / 関心領域) | 画像の中で「ここだけを処理する」と決めた矩形の範囲。この記事では印鑑を探す範囲を指します |
| 二値化 | 画像を「インクの画素(黒)」と「紙の画素(白)」の2値に分けること。以降、インクと判定された画素をインク画素と呼びます |
| Hough円変換 | 画像から円を見つける古典的な手法。円の候補すべてに投票させ、票が集まった円を採用します(従来版で使用) |
| RANSAC | ノイズだらけの点群から図形を見つける手法。点をランダムに選んで図形を作り、それを支持する点が多いものを採用します(今回導入) |
| インライア | ある図形を「支持している」点。円の場合、円周の近くに乗っている点のこと |
| CLAHE | 画像の明暗を局所的に強調する処理。薄くて見えないものを浮かび上がらせるのに使います |
| 明度バンド | 画像を明るさの範囲で何段階かに切り分けたもの。濃い印と薄い印を分けて扱うために使います |
| HSV / YCrCb | 色の表し方(色空間)。HSVは「色味・鮮やかさ・明るさ」、YCrCbは「明るさ・赤み・青み」で色を表します |
| モルフォロジー演算 | 白い領域を膨らませたり削ったりする処理。CLOSEは隙間を埋めて繋げる、OPENは細い部分を切って分ける、という使い方をします |
| 輪郭(contour) | 画像中の塊のふちを、点の並びとして取り出したもの |
| 円形度 / 矩形度 | その形が「どれくらい円に近いか」「どれくらい四角に近いか」を0〜1で表す指標 |
| NMS(Non-Maximum Suppression) | 重なった検出結果のうち、最も良いもの1つだけを残して他を捨てる処理 |
開発環境
精度の検証を重ねた結果、以下の構成を採用しました。
Azure Document Intelligence
OCRには引き続きAzure Document Intelligenceを使用しました。今回のアップデートで新たに活用したのが、word(単語)単位の座標情報です。
従来版はline(行)単位の情報しか使っていませんでしたが、押印もれを判定するには「押印欄に印字された『印』という1文字が、ページ上のどこに、どんな大きさで、どんな傾きで置かれているか」を知る必要があります。この粒度の情報はword単位でしか得られません。
OpenCV / NumPy
円検出のアルゴリズムを Hough変換からRANSACベースの自前実装へ全面的に置き換え ました。後述する「吸着」「弧長比検証」といった処理はOpenCVの既製関数には無いため、NumPyでベクトル化して実装しています。
Python
画像処理とOCR結果の突き合わせを一つの言語で完結させるため、引き続きPythonを使用しています。
従来版の構成とその限界
まず、従来版がどう実装されていたかを整理します。
| ステージ | 手法 | 役割 |
|---|---|---|
| Stage1 | HSV色空間での赤色領域検出 | 朱肉印鑑を色で拾う |
| Stage2 | ROI内のHough変換+強度スキャン | 「印」の周辺で円を探す |
| Stage3 | ページ全体のHough変換 | Stage1・2で見つからない場合の保険 |
この構成には3つの限界がありました。
1つ目は、Hough変換が「点の位置」しか見ないこと です。Hough変換は円周上に画素が乗っているかを投票で数えるため、丸囲み文字も、罫線が交差してできた角も、網掛け模様も、条件が揃えば円として検出されます。実際の印影は「かすれた曲線の連なり」ですが、Hough変換にはそれを見分ける手段がありません。
2つ目は、Stage3が誤検出の温床になっていたこと です。ページ全体を探索範囲にすると、印鑑ではない円が大量に見つかります。
3つ目は、押印もれという概念が無かったこと です。従来版の出力は has_stamp(印鑑があるか)というbool値でした。「押すべき箇所がいくつあるか」を数える仕組みが存在しませんでした。
開発プロセス
今回の最大のテーマは、拾いすぎをやめることでした。
▼ 旧プロセスの課題
赤色検出 → 見つからなければROI内Hough → それでも見つからなければ全ページHough → 1つでも見つかれば「押印あり」
段階的にフォールバックする構造上、後段ほど探索範囲が広く、精度が低くなります。そして最後の全ページHoughは、探索範囲がページ全体なので、印鑑らしき円が見つかるまで探し続けます。結果として、印鑑が押されていないページほど誤検出が並ぶという逆転が起きていました。下記画像で円が描かれている部分が誤検出です。


▼ 新プロセスの改善点
OCRのword情報から「押印すべき箇所」を数える → Stage1・Stage2を両方実行して印鑑を検出 → 印鑑を各箇所に割り当てて充足を判定
新しいフローでは、検出(印鑑を見つける)と判定(押印もれを数える)を完全に分離しました。判定側は「OCRのword」と「採用済みの印鑑座標」だけを入力に取り、検出方式に依存しません。
1. 押印すべき箇所を数える
最初に解くべきは「この書類には押印欄がいくつあるか」でした。
当初は「ご本人」「代理人」といった記名欄の見出し語から欄を推定する方式を検討しましたが、表本文の値を欄と取り違えるケースが多く断念しました。最終的に採用したのは、押印欄に印字されている「印」「㊞」そのものを数える方式です。
この方式には一見すると欠陥があります。朱肉が「印」の印字を覆い隠すと、OCRが読めず母数から落ちてしまうのです。
問題は、本文中に現れる「捺印」「押印」「印刷」「検印」といった熟語の「印」を除外することでした。これらを母数に入れると必要数が水増しされ、押印済みの書類が「もれあり」になってしまいます。
実データの分布を測った結果、2つの条件で分離できることが分かりました。
constants.py
# 隣接文字との横の隙間(×その文字の幅)の下限。これ未満の側があれば
# 「捺印」「押印」「印刷」「検印」のような文章・熟語の中の印とみなして
# 母数から外す。実データ(verification 100件・全ページ)では文章中の印が
# 最大 1.18(小さなセル内の「検 印」)、押印欄の印が最小 1.47
# (「㊞ (ご本人との続柄」)で分離するため、その中間に置く。
SEAL_MARK_ISOLATION_MIN_GAP = 1.3

# 隣接文字とみなす縦のずれ(×文字高)。「同じ行に重なる語」だけを見ると、
# 縦書きセルの「印鑑照合」のように印の真上・真下にある文字を見逃し、
# 熟語の一部が押印欄として母数に入る。
SEAL_MARK_NEIGHBOUR_MAX_V_GAP = 0.5

2. Stage1(朱肉印鑑)を「外枠を囲む1領域方式」へ
従来版のStage1は、HSV色空間で赤色領域を検出し、その形状をHough系の緩和条件で評価していました。しかしこの方式では、印影が「かすれた枠」と「中身の文字」に分裂し、1つの印鑑から複数の候補が生じます。そのためNMS(重複除去)、マージ、救済といった後処理が必要でした。
新方式では発想を変え、「赤が検出できたところ」から外側へ辿って一番外枠を囲み、それを1つの印鑑の範囲とする 構成にしました。
stamp/red.py
def _seal_regions(red_mask: np.ndarray, img: np.ndarray) -> list[RedCandidate]:
    """検出赤を種に、外枠まで連結した塊ごとに 1 つの印鑑範囲を作る。

    手順:
      1. 検出用より緩い感度で赤をなぞり、かすれた薄い枠まで拾う。
      2. CLOSE で飛び飛びの枠断片・枠と中身を連結し、1 印鑑を 1 つの閉じた塊にする。
      3. 各外枠を塗りつぶして中身の詰まったシルエットにし、OPEN で「別々の印を
         薄い赤で繋いだ細いくびれ」を切る(印本体は太いので残る)。
      4. RETR_EXTERNAL で「一番外枠」だけを取る(入れ子の内側文字輪郭は自動除外)。
      5. 各外枠について、内側に「検出できた赤」を十分含むものだけを印鑑候補とし、
         外枠の円形度/矩形度で規則的な形(円・四角)か殴り書きかを判定する。

    1 塊 = 1 候補なので、同じ場所に複数候補が生じず、NMS・マージも要らない。
    """
ポイントは手順3です。先に外枠を塗りつぶして「中身の詰まったシルエット」にしてからOPEN処理をかけます。薄いリング状のまま処理すると印鑑自体が分断されてしまいますが、塗りつぶしておけば印本体は直径が十分大きいので残り、隣接した別々の印を繋いでいた細いくびれだけが切れます。
色空間もHSVからYCrCbへ変更しました。Cr成分で赤の優勢を見て、Cb成分の下限で黄・橙・茶を、上限で青紫を落とします。明度(Y)は無制限にすることで、薄い印も濃い印も同じ条件で拾えるようにしています。
印鑑ではない赤い要素を落とす最終ゲート
さらに、赤ペンの囲みメモや付箋を落とす最終ゲートを追加しました。特に効果があったのが インク密度のばらつき による判定です。
印鑑は「枠」と「文字」で密度に構造があるため、8×8グリッドに割った各セルの密度の標準偏差が大きくなります。一方、赤ペンの囲みメモや付箋は大領域で密度が均一なため、標準偏差が小さくなります。
stamp/red.py
# 大きな囲みメモ・付箋の除外。付箋は密度が一様だが、印鑑は枠と文字で密度に構造が
# ある。8x8 グリッドのインク密度の標準偏差で見分ける。小さい円には適用しない。
「密度そのもの」ではなく「密度のばらつき」で見るのがコツでした。

3. Stage2(黒印鑑)をHoughからRANSAC+吸着へ
最も苦労したのがStage2です。朱肉ではない黒・紺の印鑑には色の手がかりが無いため、形だけで判断する必要があります。
従来版のHough変換をやめ、top-down(探索)とbottom-up(検証)の2段構成 にしました。
stamp/faint.py
"""Stage2(黒印鑑)の検出本体。

色の手がかりが無いので 2 段構成をとる。

  top-down(探索)
    明度バンドごとに RANSAC で円の候補を列挙し、インクの向きが接線と揃う円へ吸着
    させる。RANSAC は点の位置しか見ないので枠線でない円にも当たり、それを吸着で正す。

  bottom-up(検証・主判定)
    確定した円周に「曲がったインクの連なり」が実在するかを実長で測る。白紙・印字行・
    網掛けは曲がった弧を作らないので、ここで落ちる。

採否の評価は全バンドの和(=ページのインク全体)で行う。閾値は
constants.StampFaintParams を参照。
"""
前処理として、まず画像にCLAHEをかけてから明度バンドに分割します。薄い印の枠線は、生のグレースケールを二値化すると消えてしまうためです。ただしバンド分割は候補を作るためだけに使い、採否の評価は全バンドの和(=そのページのインク全体)で行います。バンドごとに評価すると、階調をまたぐ薄い印は円周が虫食いになって過小評価されてしまいます。
「吸着」という処理を導入した のが今回の肝です。RANSACで当てた円は、点の位置しか見ていないため本来の枠線から微妙にずれます。そこで、円周上のインクの向き(局所窓内の分布の第1主成分)が接線方向とどれだけ揃っているかを指標にして、近傍を探索しながら本来の枠線へ円を乗せ直します。
この「接線一致度」という指標には、副次的な効果もありました。
stamp/faint.py
def _tangential_profile(...):
    """同一中心の複数半径について (接線一致度, 円周被覆, 角度ごとのインク有無) を返す。

    枠線の接線方向は角度とともに回転するが、網掛けの格子方向は全域で一定なので、面の
    上にどんな円を引いても接線一致度は稼げない。
    """
網掛け模様は格子の方向が全域で一定なので、その上にどんな円を引いても接線一致度は上がりません。従来版が苦しんでいた「網掛けの上に立つ偽円」が、この指標だけで自然に落ちるようになりました。
4. 弧長比による最終検証
吸着まで済ませても、まだ偽円は残ります。決定打になったのが、bottom-upの 弧長比 検証でした。
stamp/faint.py
def _arc_length_on_circle(ink: np.ndarray, cx: int, cy: int, r: int) -> float:
    """円周に乗っている「曲がったインクの連なり」の実長 ÷ 円周 を返す。

    Stage2 の主判定。長さを直接足すので、許容距離を広げても値は稼げない。
    探索には使わない(理由は constants の VERIFY_ARC_LENGTH_MIN 参照)。
    """
円周被覆・リング密度・接線一致度といった指標は、いずれも「円周の近くに画素があるか」を数えているに過ぎません。そのため字画や網掛けでも高い値が出てしまい、本物の印影との分布が重なります。
一方、弧長比は輪郭を弧に分割し、直線的な断片を捨てた上で、円周に乗っている部分の長さを直接足します。長さを足すという性質上、許容距離を広げても値は稼げません。この指標だけが、偽円と余裕を持って分離できました。

5. Stage3の廃止と、Stage2の常時実行
誤検出の主因だった全ページHough(Stage3)は廃止しました。探索範囲は「印」マーカー周辺のROIと、署名欄を右下へ拡張したアンカーROIに限定しています。
探索範囲を絞ることが、そのまま誤検出の削減になります。 印鑑が押されるのは押印欄か署名欄の近くであって、本文の途中でも余白でもありません。ページ全体を探す必要は、そもそも無かったわけです。
一方で、Stage1(赤)とStage2(黒)の関係は逆に変更しました。従来版は「赤が見つかればそこで終了」でしたが、これでは赤い印鑑と黒い印鑑が混在する書類で取りこぼしが生じます。新方式では Stage2を常に実行し、Stage1で採用済みの印と重なる円だけを重複として除外 します。
service.py
# Stage 2: 「印」マーカー ROI + 署名欄アンカー ROI を RANSAC 円検出で探索。
# アンカー ROI は署名フィールド近傍を右下へ拡張した矩形。
# Stage1 検出ページでも動かし、Stage1 の座標に無い印を追加で拾う。
circle_candidates = self._stamp_detector.detect_circle_stamps(
    img, seal_marks, anchor_rois
)
# Stage1(赤)で既に採用済みの印と重なる円は重複なので除外する。
_suppress_circles_overlapping_red(circle_candidates, red_candidates)
6. 押印もれの判定
検出された印鑑を、数え上げた「印」に割り当てます。ここで重要なのは、同じ印鑑を複数の欄で使い回さない ことです。
seal_coverage.py
def judge_seal_marks(...) -> list[SealMarkJudgement]:
    """独立した「印」ごとに、近傍へ印鑑が押されているかを判定する。

    母数は「押印欄のプレースホルダとして単独で置かれた印」の数。印鑑を1個
    見つけるたびにその印を母数から引き、引ききれなかった印が押印もれになる。

    同じ印鑑を複数の印に使い回さないよう、割り当てた印鑑は候補から取り除く。
    印から離れた場所にある印鑑(欄外の代表者印など)はどの印にも割り当たらず、
    判定に影響しない。
    """
判定結果は3値にしました。充足 / もれあり に加えて、判定不能 を独立させています。
これは設計上、最も慎重に議論した点でした。
| 倒し方 | 起きること |
|---|---|
| 「判定不能」を「もれ」へ | 必要数と押印数が一致したまま「未押印0箇所」という無意味な警告が出る |
| 「判定不能」を「充足」へ | OCRが取れなかった書類が「確認した結果もれなし」に化ける |
後者は 見落としを見落としたまま報告する ことになります。どちらも実務上は許容できないため、3値目を設けました。
7. 実行時間の最適化
新方式は精度と引き換えに計算量が増え、当初はmaster比で 実行時間が4倍 に達していました。実用に耐えないため、以下の最適化を施して 約1.5倍 まで削減しました。
- 接線プロファイルのキャッシュ:吸着探索がバンドごとに同じ近傍を舐め直すため、キャッシュが無いと同一計算を数千回繰り返していました
- バンドをまたぐ種の重複潰し:同じ円が複数の明度バンドから出てくるため、先に潰しておかないと重い吸着・判定をバンドの数だけ繰り返すことになります
- RANSACの角度計算をインライアに限定:全ペアに
arctan2をかけていた1行が、Stage2の実行時間の大半を消費していました - 粗探索での枝刈り:粗探索の最良値が閾値に届かなければ、微探索そのものを省略します
出力結果
新プロセスによる判定結果はログに出力されます。
[押印もれ] PDF=契約書_20260801.pdf ページ=3 書類=福祉用具レンタル契約書: 必要 3 箇所中 2 箇所のみ押印(未押印 1 箇所)
[押印チェック] PDF=重要事項説明書_20260801.pdf ページ=1 書類=重要事項説明書: 押印もれなし(必要 2 / 押印 2)
[押印チェック] PDF=居宅サービス計画書.pdf ページ=2 書類=居宅サービス計画書: 判定不能(押印必要箇所を確認できず)
検出された印鑑・サインは、1件ずつクロップ画像として切り出して保存しています。


従来版との比較
今回のアップデートによる変化を整理しました。
- 円検出: Hough変換(点の位置のみで判定)
+ 円検出: RANSAC + 吸着 + 弧長比検証(形の連続性で判定)

- 探索範囲: 最後は全ページ(見つかるまで探す)
+ 探索範囲: 「印」ROI と署名欄アンカー ROI に限定(Stage3は廃止)

- Stage1の後処理: NMS・マージ・救済が必要
+ Stage1の後処理: 不要(1塊=1候補)

- 判定できること: 印鑑が写っているか(bool)
+ 判定できること: 押印必要箇所のうち何箇所が押されているか(ログ出力)

+ 実行時間: master比 約1.5倍
検証に用いたサンプル100件では、開発時点で誤検出をゼロに抑えられています。 実行時間は増加していますが、拾いすぎをやめるために形の連続性まで見るようになったぶんのコストと考えています。

今後の展望
今回の検出は、閾値をすべて人の手で決めた古典的な画像処理で組んでいます。実データの分布を測り、その中間に閾値を置く。この進め方で誤検出はゼロまで持っていけましたが、方式としての限界も見えています。
- 新しい様式の帳票が出てくるたびに、分布を測り直して閾値を調整する必要がある
- 「円形度」「弧長比」のように、人間が思いついた指標しか使えない
- 指標同士の重み付けは、結局のところ経験と勘で決めている
次の一手として考えているのが、印鑑そのものの学習です。検出した印影のクロップは1件ずつ保存され続けているため、「印鑑か、そうでないか」の教師データは運用しているだけで貯まっていきます。丸囲み文字や罫線の交差といった、今回わざわざ指標を考えて落とした対象も、学習器なら「印鑑らしくないもの」としてまとめて扱えるはずです。
古典的な画像処理で「どこを探すか」を絞り込み、最終的な採否だけを学習器に任せる。この組み合わせが、精度と処理速度の両立には現実的だと考えています。
今後も、より便利で高性能なAIツールの開発に取り組んでいきます。


