
こんにちは。AILabの堂上拓です。
今回はMicrosaas開発シリーズとして、複数の書類が連結されたPDFを「書類単位」に自動分割するパイプラインに、ユーザー修正からの学習機能を組み込むプロトタイプを実装しました。 このプロトタイプは、ユーザーが一度行ったページ分割操作(書類の分割・結合)を学習データとしてDBに蓄積し、次回以降の同じフォーマットのPDF処理時に自動的にページ境界を再現することで、分割修正の手間を漸進的に減らしていく仕組みです。
以下のような、複数の書類が1つのPDFに連結された状態、皆さんも一度は目にしたことがあるのではないでしょうか?
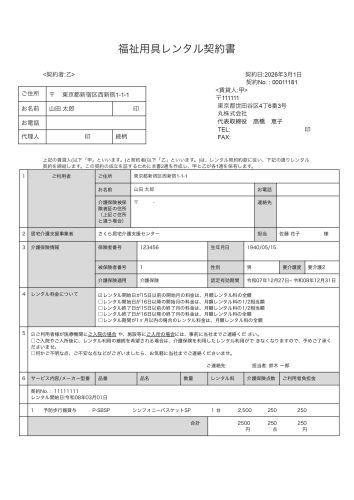
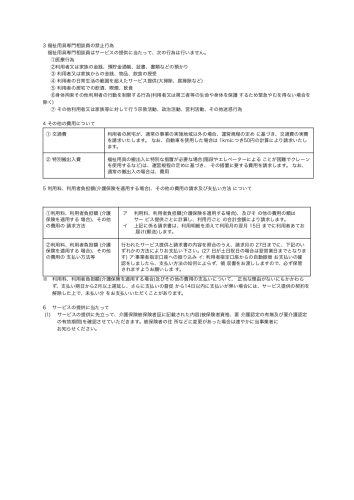
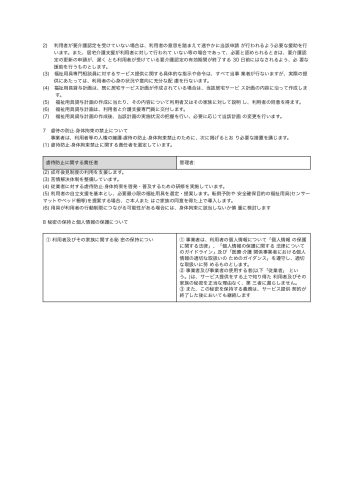
これらのPDFについて、ユーザーが毎回手動で分割位置を修正するのは非効率です。 今回開発したプロトタイプは、ベクトル類似度・統計的投票を組み合わせて、その分割を自動再現するものです。
本プロトタイプの特徴:LLMに頼らない構造的学習アプローチ
本プロトタイプの最大の特徴は、書類の同一性判定とページ境界判定を、LLMに頼らずベクトル空間でのスコアリングと統計的投票で実現しているという点です。
近年、ChatGPTやClaudeなどの大規模言語モデル(LLM)を使って書類処理を行うアプローチが注目されていますが、本プロトタイプではあえてLLMを使わず、以下の理由から構造的・統計的アプローチを採用しました。
LLMを使わないメリット:
- 低コスト: LLM APIの呼び出しコストが不要。学習データが増えても運用コストは一定
- 判定根拠が説明可能: スコアの内訳(OCR配置 / 罫線 / 意味的類似度 / タイトル等)をログから追えるので、誤判定時にどの次元が原因かが分かる
- 安定した出力: 同じ入力に対して常に同じ結果を返す(LLMの「揺れ」がない)
- 段階的に学習が積み上がる: ユーザー修正のたびに学習データがDBに蓄積され、判定精度が漸進的に上がる
- デバッグ容易: 各処理ステップが明確で、問題発生時の原因特定が容易
本プロトタイプで使用している主な技術:
- GiNZA(spaCy互換): ページ全文の意味的類似度をコサイン類似度で算出する部分のみ機械学習を使用
- OpenCV・PyMuPDF: ページ画像のエッジ構造(罫線/枠線)をベクトル化
それ以外の処理(書類シグネチャ構築、境界判定の投票、3層フォールバック)は全て、ベクトル演算・統計処理といった決定論的なアルゴリズムで実現しています。
それでは開発の経緯とプロトタイプの仕組みについてご説明します。
目次
開発環境
本プロトタイプで使用した技術スタックと構成は以下のとおりです。
GiNZA(日本語NLP)
書類の意味的類似度の計算にGiNZAの文埋め込み機能を活用しました。 レイアウトはほぼ同じだが中身が違う書類、逆に中身は連続するがレイアウトが少し違う書類、というケースを区別するために使用しています。
OpenCV・PyMuPDF
PDFから罫線・枠線などのエッジ構造を検出するために、OpenCV(画像処理)とPyMuPDF(PDF→画像変換)を使用しました。 ページ画像をCannyエッジ検出にかけ、20×20のグリッドに分割してセルごとのエッジ密度をベクトル化することで、レイアウトの構造的類似度を算出します。
NumPy
8次元の特徴量ベクトル演算(コサイン類似度、加重平均、正規化など)にNumPyを使用しています。
SQLModel・Alembic
学習データを永続化するために、SQLModelで2つのテーブル(layout_templates、boundary_training_samples)を定義し、Alembicでマイグレーションを管理しています。
Python
全体の処理をPythonで実装しています。主要なライブラリは以下の通りです:
spacy+ja_ginza: 日本語NLP・文埋め込みopencv-python: 画像処理PyMuPDF (fitz): PDF処理numpy: ベクトル演算
処理フロー概要
本プロトタイプの処理フローを図にまとめると、以下のようになります。
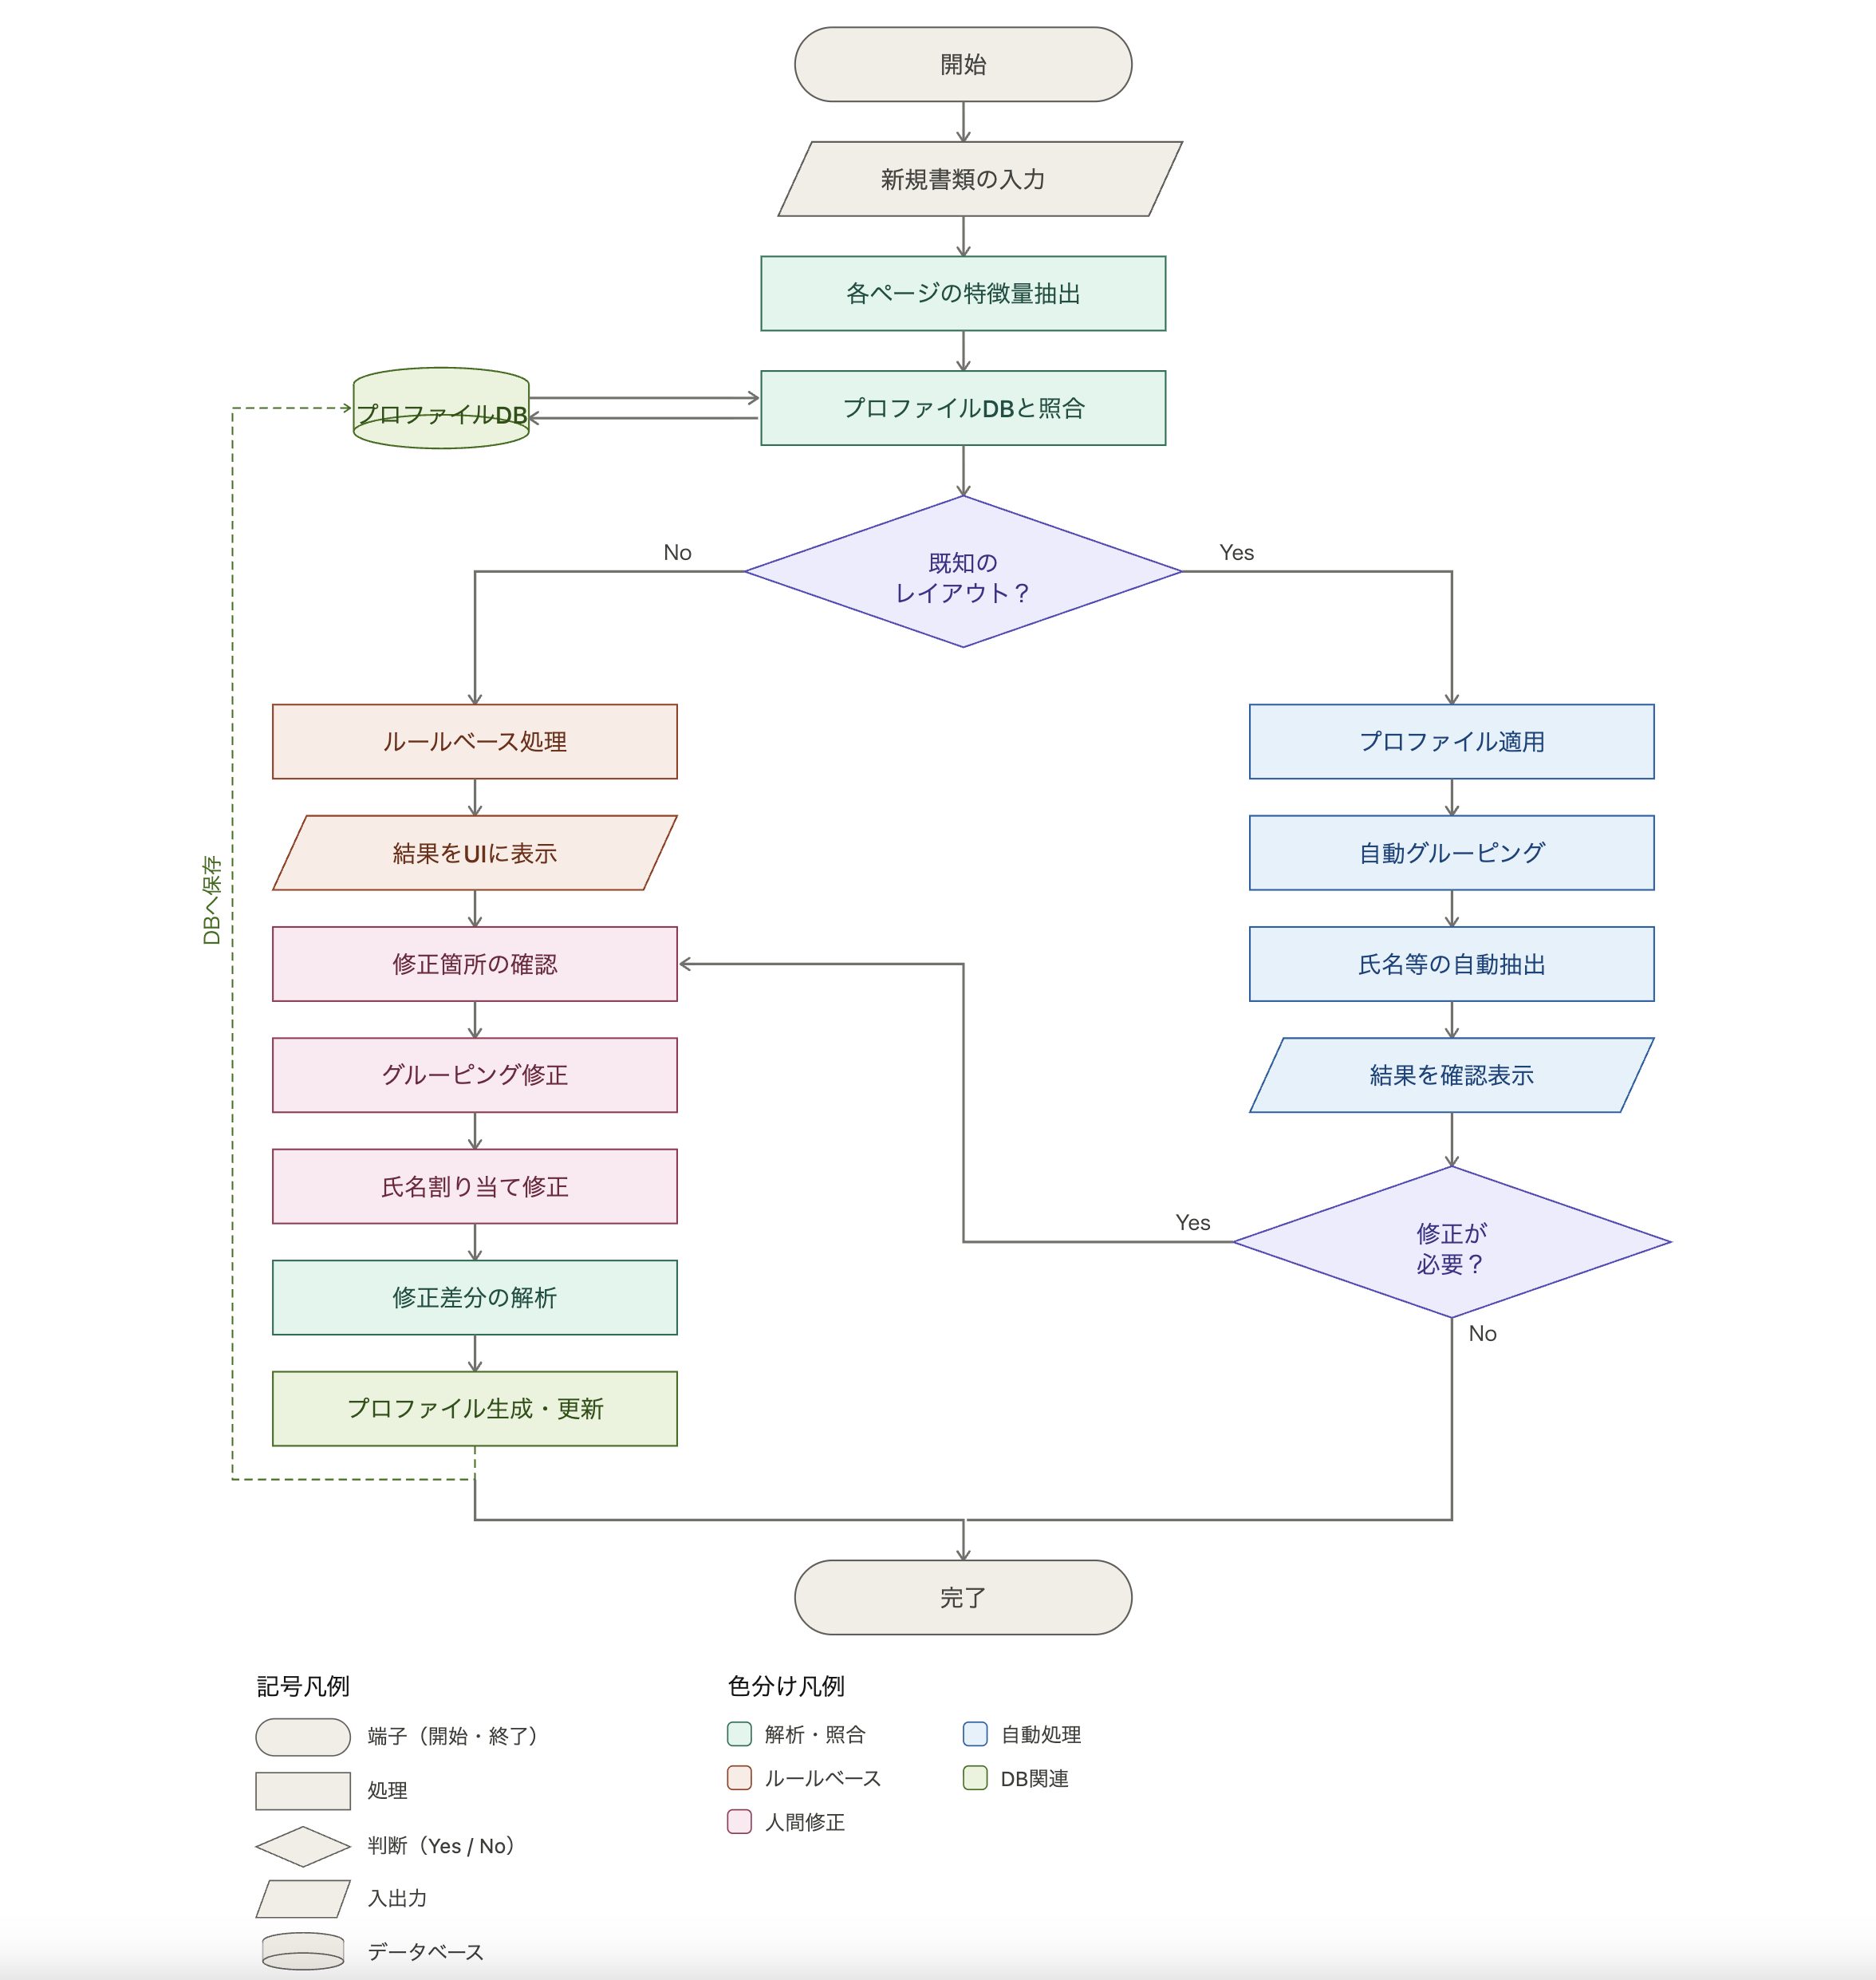
図のポイントは、新規書類が入力されたときに「レイアウト判定」で過去のプロファイルDBと照合する分岐があることです。
- 未知レイアウトの場合(左側ルート): ルールベース処理でグルーピング → UIに結果を表示 → 人間が修正 → 修正差分を解析 → プロファイルDBに保存。学習の起点になるルートです
- 既知レイアウトの場合(右側ルート): 過去のプロファイルを適用して自動グルーピング → 結果を確認表示。修正が不要ならそのまま処理完了、必要なら人間修正のループに戻る
つまり、本プロトタイプは「未知レイアウトはルールベースで処理しつつ、人間の修正からプロファイルを学習し、次回以降は既知レイアウトとして自動処理する」というフィードバックループを実装したものです。
文章で書き下すと、処理ステップは以下のとおりです:
- PDF読み込み → PDFファイルを入力として受け取る
- OCR・LLM抽出 → 既存ステップで各ページのテキストとフィールド値を抽出
- ページ特徴量抽出 → 各ページから8次元の特徴量を計算
- 書類シグネチャ構築 → ページ特徴量を集約してPDF全体のシグネチャを作成
- レイアウトマッチング → 過去のテンプレートと比較し、既存書類か新規書類かを判定
- 境界判定(グルーピング) → 3層フォールバックでページを書類単位に分割
- マスターデータ作成 → 構造化されたデータとして出力・DB保存
- UI修正の学習 → ユーザーの分割/結合操作から境界学習サンプルをupsert
以下では、各ステップについて詳しく説明していきます。
書類シグネチャの構築
書類の同一性を判定する核となるのが、8次元のページ特徴量を組み合わせた書類シグネチャです。
各次元は固定の重みを持ち、合計が1.0になるよう正規化されています。
| 次元 | 重み | 概要 |
|---|---|---|
| エッジ構造 | 0.25 | 罫線・枠線の位置/形状ベクトル類似度 |
| 意味的類似度 (GiNZA) | 0.20 | OCR 全文の文埋め込みコサイン類似度 |
| OCR 配置 | 0.15 | OCR 行の位置ベクトル類似度 |
| 遷移 | 0.10 | ページ間の構造変化パターン |
| タイトル | 0.10 | 書類タイトル文字列の一致度 |
| 副題 | 0.10 | 副題文字列の一致度 |
| テキスト密度 | 0.05 | ページ内のテキスト量分布 |
| OCR 行数 | 0.05 | 検出された OCR 行の総数 |
設計上のポイントは、「文字配置・罫線」と「意味的類似度」を同じくらい主要次元に据えた点です。レイアウトだけ似ていて中身が違う書類、逆にレイアウトが微妙に違うが意味は同じ続きの書類、どちらも判別できるようにするためです。
エッジ構造のベクトル化
PDFページを画像化し、OpenCVのCannyエッジ検出で罫線・枠線を抽出した後、20×20のグリッドに分割してセルごとのエッジ密度を計算します。
def _vectorize_edge(
    pdf_path: str,
    page_index: int,
    grid_rows: int = 20,
    grid_cols: int = 20,
) -> np.ndarray:
    """PDFページを画像化し、エッジ検出でレイアウト構造をベクトル化する。"""
    vector = np.zeros(grid_rows * grid_cols)

    with fitz.open(pdf_path) as doc:
        page = doc.load_page(page_index)
        pix = page.get_pixmap(matrix=fitz.Matrix(2, 2), alpha=False)
        img = np.frombuffer(pix.samples, dtype=np.uint8).reshape(
            pix.height, pix.width, 3
        )

    gray = cv2.cvtColor(img, cv2.COLOR_RGB2GRAY)
    edges = cv2.Canny(gray, 50, 150)

    kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (3, 3))
    edges = cv2.dilate(edges, kernel, iterations=1)
    edges = cv2.erode(edges, kernel, iterations=1)

    h, w = edges.shape
    cell_h = h / grid_rows
    cell_w = w / grid_cols

    for row in range(grid_rows):
        for col in range(grid_cols):
            y1 = int(row * cell_h)
            y2 = int((row + 1) * cell_h)
            x1 = int(col * cell_w)
            x2 = int((col + 1) * cell_w)
            cell = edges[y1:y2, x1:x2]
            if cell.size > 0:
                vector[row * grid_cols + col] = np.sum(cell > 0) / cell.size

    max_val = vector.max()
    if max_val > 0:
        vector = vector / max_val
    return vector
意味的類似度(GiNZA)の導入
レイアウトはほぼ同じだが中身が違う、逆に中身は連続するがレイアウトが少し違う、というケースに対応するため、GiNZAの文埋め込みベース類似度を導入しました。
def compute_semantic_similarity(text_a: str, text_b: str) -> float:
    """2 つの日本語テキストの意味類似度を 0.0〜1.0 で返す。

    GiNZA で文単位のベクトルを作り、コサイン類似度を計算。両方が空文字や、
    モデルロード失敗時は 0.0(完全に異なる扱い)を返す。
    """
    if not text_a or not text_b:
        return 0.0
    nlp = _get_nlp()
    if nlp is None:
        return 0.0
    try:
        doc_a = nlp(text_a[:MAX_CHARS])
        doc_b = nlp(text_b[:MAX_CHARS])
        if (
            getattr(doc_a, "vector_norm", 0.0) == 0.0
            or getattr(doc_b, "vector_norm", 0.0) == 0.0
        ):
            return 0.0
        sim = float(doc_a.similarity(doc_b))
        return max(0.0, min(1.0, sim))
    except Exception as exc:
        logger.warning("semantic similarity computation failed: %s", exc)
        return 0.0
GiNZAモデルは初期化コストが高いので、thread-localにキャッシュして再ロードを避けています。
レイアウトマッチング
書類シグネチャが構築できたら、過去に保存したテンプレート群と比較し、既存書類か新規書類かを判定します。
# 書類が既存テンプレートに一致するとみなす総合スコアの下限。
MATCH_THRESHOLD = 0.80

# サブシーケンスマッチ(長尺PDFの中に既存テンプレートが部分一致しているか)用の閾値。
# 全体マッチより厳しめに設定:窓を動かすと偶然似た区間を拾いやすく、過検出の
# リスクが高いため。
SUBSEQUENCE_MATCH_THRESHOLD = 0.85
総合スコアが0.80以上なら既存書類とみなし、保存済みの境界フラグをそのまま流用します。 全体マッチが閾値未満でも、シグネチャの一部が既存テンプレと連続一致する場合はサブシーケンスマッチ(閾値0.85)として、その区間だけ既存テンプレを再利用します。これは「複数書類が連結された長尺PDF」や「ページ数が違うが一部は既知の書類」に対応するためです。
ページ境界判定(グルーピング)
本プロトタイプの中核処理です。 PDFを1つの書類単位(ChunkedFile)に分割するために、以下の3層フォールバックで境界を判定します。
- テンプレート流用層: 既存テンプレートに境界フラグがあればそのまま分割(一番強い)
- 学習サンプル投票層: 隣接ページ間の特徴量を、過去の境界・非境界サンプルの中央値と比較し重み付き投票
- 3キー差分層: 利用者名 / 副題 / 書類タイトル のどれかが隣接間で変わったら境界とみなすフォールバック
上位の層が判定を返せなかった場合に下位にフォールバックする構造になっており、学習データが溜まるほど上位層で判定が完結しやすくなります。
テンプレート流用層
書類シグネチャが既存テンプレートにマッチ(スコア > 0.80)し、かつそのテンプレートに正準境界フラグが保存されている場合は、テンプレートのフラグをそのまま新PDFに適用します。
これが最も信頼度の高い判定で、過去にユーザーが確定させた境界をそのまま再現できます。
サブシーケンスマッチで部分一致した区間も、その区間内ではテンプレートのフラグを適用します。区間の境目(カバー外と内の切り替わり)は強制的に境界扱いとし、未カバー区間は下位層に委ねます。
学習サンプル投票層
テンプレート流用層で判定できない場合、隣接ページ間の特徴量を計算し、過去の境界学習サンプルと比較して重み付き投票で判定します。
特徴量は7次元(OCR/エッジ/タイトル/副題/テキスト密度/行数/意味的類似度)で、各次元の重みは前段のシグネチャ重みから「遷移」を除外して合計1.0に再正規化したものを使用します。
# 学習サンプル投票を信用するために必要な最小サンプル数(境界/非境界 合算)。
MIN_SAMPLE_COUNT = 3

# 境界スコアと非境界スコアの差がこれ未満なら判定が拮抗しているとみなし、
# confident=False を返す。FEATURE_WEIGHTS は合計1に正規化されているので、
# 0.1 は「寄与重み1割以上の明確な差」を要求する閾値。
CONFIDENCE_MARGIN_THRESHOLD = 0.1
具体的には、新PDFの隣接ページ対の特徴量を、過去の境界サンプルの中央値・非境界サンプルの中央値とそれぞれコサイン類似度で比較し、近い方を採用します。
学習サンプル投票の信頼性ガード
学習サンプルが少ないうちは、投票結果が偏って常に同じ判定を返してしまいます。これを回避するため、以下のガードを入れています。
具体的には以下のいずれかに該当すれば confident=False を返し、呼び出し側が3キー差分フォールバックに委ねる設計です。
- サンプル合計 < 3件 → 学習データ不足
- 境界サンプルか非境界サンプルが片側だけしか無い → 構造的に偏った投票しかできない
- スコア差 < 0.10 → 拮抗判定
特に「片側欠落の検出」が重要で、これを入れていないと最初の数十書類では「常に同じ判定」を返す状態に陥ります。
3キー差分層(最終フォールバック)
上位2層がいずれも判定を返せない場合の最終フォールバックです。 隣接2ページ間で「利用者名 / 副題 / 書類タイトル」のどれかが変化していれば境界、変化していなければ非境界と判定します。
def _adjacent_group_key_changed(
    prev_page: dict[str, Any],
    curr_page: dict[str, Any],
) -> bool:
    """隣接2ページ間で (user_name, subtitle, document_title) が変化したかを返す。

    学習サンプル投票の信頼度が低い場合のフォールバック判定に用いる。
    master ブランチのバケット方式と同じ3キーを、隣接差分として使う。
    """
    prev_summary = prev_page.get(PageDataKeys.SUMMARY_JSON, {}) or {}
    curr_summary = curr_page.get(PageDataKeys.SUMMARY_JSON, {}) or {}
    prev_key = (
        prev_summary.get(SummaryJsonKeys.USER_NAME),
        prev_summary.get(SummaryJsonKeys.SUBTITLE),
        prev_summary.get(SummaryJsonKeys.DOCUMENT_TITLE),
    )
    curr_key = (
        curr_summary.get(SummaryJsonKeys.USER_NAME),
        curr_summary.get(SummaryJsonKeys.SUBTITLE),
        curr_summary.get(SummaryJsonKeys.DOCUMENT_TITLE),
    )
    return prev_key != curr_key
これは従来のバケット方式(同じキーのページを1グループにまとめる方式)と同等のロジックを、隣接差分として再構成したものです。学習が積み上がる前の初期状態でも、最低限の品質で境界判定ができるようにしています。
ユーザー修正からの学習
ここからが本プロトタイプのもう一つの肝、境界学習レイヤーです。 ユーザーがUI上で書類を分割(split)または結合(merge)したとき、その操作結果を学習データとして記録します。
全構造記録 + upsert
ユーザーがチャンクを分割/結合した後、全ての隣接ページ対に対してサンプルを記録します。
- 同一チャンク内の隣接 → 非境界サンプル
- チャンク間の隣接(残った境界)→ 境界サンプル
これにより「ユーザーが手を加えなかった境界」も学習に乗ります。従来は操作点だけ記録していたため、片側偏りで投票が機能しないという問題がありました。
サンプルは (ファイルID, 前ページの元PDF上のページ番号, 後ページの元PDF上のページ番号) でユニーク識別します。同じ境界の二重記録は upsert で correction_count を +1 することで信頼度を蓄積します。
元PDF上のページ番号をキーにすることで、merge/splitでページが再作成されても識別が壊れない設計になっています。
学習フックの呼び出しタイミング
UI操作ハンドラから薄いインターフェースで学習フックを呼び出します。分割(split)と結合(merge)の両方に対して学習フックを用意しています。
def on_split(
    session: Session,
    chunked_file: ChunkedFile,
    split_page: int,
) -> None:
    """分割操作時の学習サンプル保存。

    `update_database_for_split` が元 Page を削除する**前**に呼ぶこと
    (削除後だと境界学習サンプルの upsert に必要な page 情報が取れない)。
    """
    try:
        save_split_correction(session, chunked_file, split_page)
    except Exception:
        logger.exception(
            "Failed to save split correction to layout template/samples",
        )


def on_merge(
    session: Session,
    chunked_file1: ChunkedFile,
    chunked_file2: ChunkedFile,
    pages1: list[Page],
    pages2: list[Page],
) -> None:
    """結合操作時の学習サンプル保存。

    `update_database_for_merge` が元 Page / Item を書き換える**前**に呼ぶこと。
    """
    try:
        save_merge_correction(session, chunked_file1, chunked_file2)
    except Exception:
        logger.exception(
            "Failed to save merge correction to layout template/samples",
        )
分割の場合は「新しく境界が増えた点」を境界サンプルとして、結合の場合は「ユーザーが消した境界点」を非境界サンプルとして記録します。 どちらの操作も、内部的には「操作後のチャンク構造から全隣接ページ対をスキャンしてupsertする」共通の処理に集約されているため、片方の操作にだけ偏らずに学習データが蓄積される設計です。
呼び出しタイミングが重要で、元Pageを削除・書き換える前に呼ばないと特徴量が取れません。学習処理は副次的なものなので、内部で全例外を吸収してメインフローを止めない設計にしています。
スキーマ:2つの学習テーブル
学習データはAlembicマイグレーションで以下の2テーブルを追加し、テナントDBごとに永続化しています。
- layout_templates: 書類レイアウトテンプレート(signature + 正準境界フラグ)
- boundary_training_samples: 隣接ページ対の境界判定学習サンプル
加えて、files.layout_template_id カラムをマッチしたテンプレートへのFKとして追加し、UI修正時の逆引きを高速化しました。
class LayoutTemplate(SQLModel, table=True):
    """書類レイアウトテンプレートを管理するテーブル"""

    __tablename__ = "layout_templates"

    id: uuid.UUID = Field(...)
    page_count: int = Field(
        description="テンプレートが対象とするPDFのページ数",
    )
    signature: dict[str, Any] = Field(
        description="マッチング用のページ毎特徴量(OCR/edgeベクトル、タイトル、密度等)",
    )
    is_boundary_flags: list[bool] | None = Field(
        default=None,
        description="正準グルーピング(隣接ページ対ごとの境界フラグ)",
    )
    ...
出力結果
実際に本プロトタイプを使って、同じフォーマットのPDFを2回投入してみます。
1回目:新規書類 → ユーザーが修正 → プロファイルDBに保存
1回目は新規書類として登録され、システムが自動で境界判定を行います(学習データがゼロなので3キー差分層にフォールバック)。
検証用に criterion1.pdf を投入したときの、システムによる自動グルーピング結果が以下です:

このままでは想定と異なる位置で分割されているため、ユーザーがUI上で分割/結合を行い、正しい境界に修正します:

この時点で、修正結果が boundary_training_samples テーブルに upsert され、書類テンプレートの is_boundary_flags も更新されます。
2回目:既存書類とマッチ → プロファイルが自動適用
次に、criterion1.pdf と同じフォーマットの別PDF(same_criterion1.pdf)を投入します。
書類シグネチャが1回目のテンプレートとマッチ(スコア > 0.80)し、テンプレート流用層で1回目の修正結果がそのまま再現された状態で出力されます:

ユーザー修正を行わずとも、1回目で確定させた境界位置がそのまま反映されていることが確認できます。
対応できるケース
本プロトタイプが対応できるケースを整理すると以下のとおりです:
| ケース | 1回目の状態 | 2回目の自動反映 |
|---|---|---|
| 同一フォーマットのPDF(利用者違い) | 3キー差分層で判定 → ユーザーが分割/結合で境界を修正 | テンプレート流用層で同じ位置に分割 |
| 過分割されてしまうフォーマット | 3キー差分層で過剰に分割 → ユーザーが結合(merge)で境界を消す | テンプレート流用層で境界を消した状態が再現 |
| ページ数が違うが一部は既知のフォーマット | 全体マッチせず3キー差分層で判定 | サブシーケンスマッチで既知区間だけ正しく分割 |
| 全く新しいフォーマット | 3キー差分層で判定 → ユーザー修正 | 学習サンプル投票層が機能(サンプル数が3件超えた時点から) |
このように、ユーザーが一度行った分割・結合の修正が次回以降の同じフォーマットのPDFで自動再現されるため、ページ境界の修正の手間を漸進的に減らしていくことができます。
主要な閾値
設計の最後に、本プロトタイプで使っている主要な閾値を一覧にしておきます。これらの値はベンチマーク用PDFセットで調整した結果です。
| 閾値 | 値 | 用途 |
|---|---|---|
| 書類同一性マッチ閾値 | 0.80 | 既存書類と判定する総合スコア下限 |
| サブシーケンスマッチ閾値 | 0.85 | シグネチャ部分一致で既存テンプレを再利用する際の連続区間スコア下限 |
| 境界投票の最小サンプル数 | 3 | 学習投票を有効化するサンプル数 |
| 投票の信頼マージン | 0.10 | confident=True にするスコア差下限 |
| GiNZA 入力の最大文字数 | 2000 文字 | 文埋め込み計算前のテキスト打ち切り |
今後の展望
現状のシステムには以下の課題があり、今後の改善を検討しています。
フィールド値学習への拡張
今回のスコープはページ分割に限定しましたが、次回はフィールド値(利用者名・書類タイトル・要介護度など)の修正学習に拡張する予定です。 現状ではこれらの修正は次回以降に再現されず、ユーザーが毎回同じ修正を繰り返す必要があります。
今後は、修正後の値と OCR テキストの周辺文字列を学習データとして記録し、次回の同テンプレ書類で janome 形態素解析と rapidfuzz による近似マッチで自動抽出する仕組みを実装することを検討しています。
テンプレートの統合・整理
利用者や事業所が増えると、似たフォーマットのテンプレートが乱立する可能性があります。
現状では、テンプレート数が増えるとレイアウトマッチング時の比較コストが線形に増加してしまい、長期運用での性能劣化が懸念されます。
これらの課題に対しては、以下の改善を検討しています:
- シグネチャ間の類似度をバッチで再計算し、閾値以上のテンプレートは統合するバックエンドジョブ
- テンプレート利用頻度に応じた優先度付け
- 長期間使われていないテンプレートのアーカイブ化
- テナント横断での匿名化シグネチャ共有によるコールドスタート緩和


