
こんにちは、AI Labの新宮尊です。今回は、私たちのチームで取り組んだ「FAX DM判定システムの開発と、その精度向上に向けた研究開発プロセス」について詳しくご紹介します。
私たちの提供する福祉書類管理システムでは、日々多くのFAXが届きます。その中には、業務に必要な書類だけでなく、セミナーの案内や広告といった「FAX DM」も多く含まれています。これらの不要な書類を手動で仕分けるコストを削減するため、機械学習を用いてFAX DMを自動的に判定し、読み取りフローから除外する仕組みを構築しました。
今回のプロジェクトのポイントは、単に「AIで判別する」だけでなく、「正規の書類を誤って除外しない(False Positiveの最小化)」という実運用上の極めて重要な課題に、データクリーニング、特徴量エンジニアリング、そしてパラメータチューニングを通じていかに立ち向かったかという点にあります。
開発環境
| 項目 | 内容 |
|---|---|
| 言語 | Python |
| 機械学習 | scikit-learn (GradientBoostingClassifier 等) |
| 画像処理 | OpenCV, Pillow |
| 実行環境 | Docker コンテナ |
| ソース管理 | GitHub |
| タスク管理 | Backlog |
課題の整理 ― なぜ FAX DM 判定が必要か
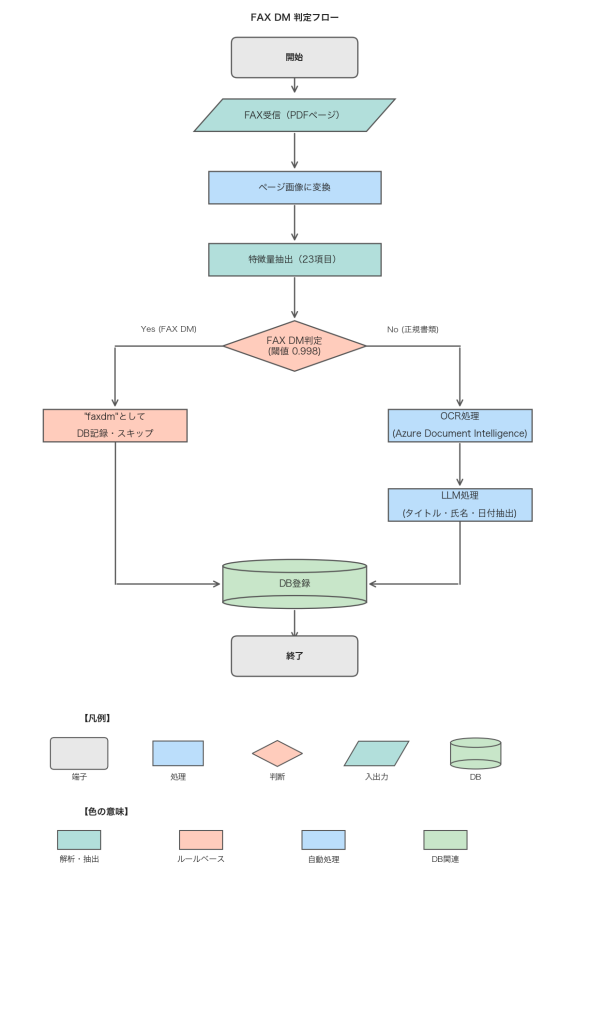
福祉書類管理システムでは、受信したFAXをPDFに変換し、OCR(Azure Document Intelligence)とLLMでタイトル・氏名・日付を抽出してDBに登録しています。OCRとLLMは1ページあたりコストが発生するため、広告FAXが大量に届いても全ページ処理される状況は無視できないコストになっていました。
そこで、OCR/LLM処理の手前にFAX DM判定レイヤーを追加しました。
判定の難しさは「正規書類にも黒っぽく見えるものがある」点にあります。セミナー案内や年末調整チラシのような FAX DMは画像や太い装飾文字が多くページ全体が黒っぽいのに対し、居宅サービス計画書やサービス提供実績記録票のような正規書類は罫線が多く、レイアウトによっては似たような印象を持ちます。この「見た目の近さ」への対処が本プロジェクト最大の課題でした。
フェーズ1 ― まず最もシンプルな方法を試す
最初のアプローチは「黒色ピクセルの比率(dark_ratio)」だけで判定するヒューリスティックです。FAX DMは画像や装飾が多くページが黒っぽく、正規書類はフォームが中心で白い部分が多い、という仮説に基づいています。
def is_faxdm(image_path: str) -> bool:
    img = cv2.imread(image_path)
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    # グレースケール80未満のピクセルを「暗い」とみなし、
    # その比率が5%以上ならFAX DMと判定
    dark_ratio = np.sum(gray < 80) / gray.size
    return dark_ratio >= 0.05
初期テストでは多くのFAX DMを検出できましたが、罫線の多い提供票や複雑なレイアウトの計画書が「暗い」と誤判定されてしまいました。閾値を調整しても根本的な解決にはならず、機械学習への移行を決断しました。
フェーズ2 ― 機械学習モデルへの移行
特徴量エンジニアリング
黒色比率だけでは「量」しか見ていないのが限界でした。そこで画像の「構造」を捉える23の特徴量を設計しました。輝度・エッジ密度・黒白比率・横線の頻度など基本的な20項目に加え、誤判定の分析を通じて以下の3つを後から追加しました。
# ① 幅80%超の横黒線の厚み平均
#    提供票の罫線は1〜2px。FAX DMは太い線が多い。
avg_long_run_thickness = ...

# ② 短い黒ラン(幅5%未満)の割合
#    文字が多い書類ほど高くなる。
short_run_ratio = ...

# ③ 黒ランの長さ分布のエントロピー
#    文字と罫線が混在する正規書類ほど多様性が高い。
run_length_entropy = ...
「罫線の太さ」は目で見れば一目瞭然ですが、これを数値化するには「1行に占める最長の黒ランが80%超の連続行数(厚み)を測る」というアイデアが必要でした。この3特徴量の追加が誤判定の大幅な改善につながりました。
アルゴリズムの比較検証
Decision Tree・Random Forest・Gradient Boostingの3アルゴリズムをGridSearchCVで最適化して比較しました。
| アルゴリズム | F1スコア | FP(正規書類の誤除外) |
|---|---|---|
| Decision Tree | 0.962 | あり |
| Random Forest | 0.978 | 0件 |
| Gradient Boosting | 0.994 | 0件 |
F1スコアが最も高くFPがゼロだったGradient Boostingを採用しました。
フェーズ3 ― 本番パイプラインへの統合
学習済みモデル(model.pkl)をOCR処理の手前に差し込み、FAX DMと判定されたページはOCR/LLMをスキップしてタイトルを "faxdm" としてDB記録します。
# OCR処理の入口(extraction_helper.py)
if self._faxdm_detector.is_faxdm(image_path, page_num):
    page_data[PageDataKeys.IS_FAXDM] = True
    page_data[PageDataKeys.SUMMARY_JSON] = {
        SummaryJsonKeys.DOCUMENT_TITLE: "faxdm",
        SummaryJsonKeys.USER_NAME: None,
    }
    logger.info("FAXDM判定: ページ %d をスキップ", page_num)
    continue  # OCR処理に進まない
判定自体はOCRを使わず画像の特徴量だけで行うため、処理は高速です。
フェーズ4 ― 閾値の最終調整と現在の限界
「お客様の重要な書類を誤って捨てないこと」を最優先とし、判定閾値を段階的に引き上げました。
| 段階 | 閾値 | FP(正規書類の誤除外) | Recall(FAX DM検出率) |
|---|---|---|---|
| ヒューリスティック | 暗色比率5% | あり | 高い |
| ML初期 | 0.75 | 0件 | ほぼ100% |
| 精度改善後 | 0.85 → 0.97 | 0件 | ほぼ100% |
| 最終 | 0.998 | 0件 | 約80% |
なぜ0.998まで上げることになったか
閾値を上げる直接の原因は、「サービス提供票」が誤ってFAX DMと判定される事象の発生でした。サービス提供票は罫線が密集しており、モデルが「黒っぽい書類」としてFAX DMに近い特徴量を算出してしまったのです。この誤判定を防ぐため、閾値を0.998まで引き上げました。
現在の精度
| 指標 | 値 | 意味 |
|---|---|---|
| Precision(適合率) | 100% | 除外した書類は全てFAX DM(正規書類の誤除外ゼロ) |
| Recall(再現率) | 約80% | 5件中1件のFAX DMが正規書類として通過してしまう |
| 全体Accuracy | 約91% | ― |
閾値0.998は「モデルが99.8%以上の確信を持つものだけをFAX DMと判定する」という極めて保守的な設定です。その結果、Precision(正規書類の保護)は達成できていますが、Recall(FAX DMの除外率)は約80%に留まっています。5件に1件のFAX DMはOCR/LLM処理に流れてしまっており、コスト削減という当初の目的を完全には達成できていない状況です。
根本的な課題
この問題の本質は、正規書類のトレーニングデータが少ない(現在44件)ことにあります。特にサービス提供票のような「黒っぽい正規書類」のサンプルが不足しているため、モデルがその判断に自信を持てず、閾値を極端に上げざるを得ない状況です。「閾値を下げてRecallを改善する」には、多様な正規書類データを追加して学習させる必要があります。
今後の展望
- 正規書類データの継続的な拡充: 多様な書式の正規書類を追加学習させることで安定性を高めます。
- 本番データのフィードバック: 個人情報保護を前提に、本番で発生した誤判定事例を匿名化して学習データに組み込む体制を検討します。
- 再学習の自動化: 変化するFAX DMのトレンドに追従できるよう、定期的な再学習パイプラインの構築を目指します。
私たちは、AI技術を活用して業務の無駄を排除し、ユーザーが本来の福祉業務に集中できる環境を提供し続けます。


