

今回は、Amazon Transcribeを使って動画からテキストを取得し、そのテキストを字幕として元動画に合成したいと思います。
元動画は前記事と同じです。
今回はpythonでスクリプトを書いて、①映像から文字データの取得、②字幕ファイルの作成を行なってみました。
映像から文字データの取得
下のスクリプトで映像から文字データの取得を行えます。
from boto3 import client

transcribe_client = client("transcribe",region_name="us-east-1",aws_access_key_id="*****",aws_secret_access_key="*****")
response = transcribe_client.start_transcription_job(
        TranscriptionJobName="ジョブ名",
        LanguageCode="en-US",
        MediaFormat="mp4",
        Media={
                "MediaFileUri": "元ファイルのURL"
        },
        OutputBucketName="バケット名"
)
ジョブ名は他と被っていなければ何でもいいです。 MediaFormatは元画像の形式を選択します。mp3,mp4,wav,flacが使えます。 元ファイルはS3に入れてある必要があります。URLとしては、https://s3-リージョン名.amazonaws.com/バケット名/…/ファイル名といった形で書きます。(例えば、https://s3-us-east-1.amazonaws.com/test/test.mp4など) OutputBucketNameには手に入れたどのバケットに保存したいかを書きます。バケット名のみで大丈夫です。 S3以外に出力先を向けることはできないようです。
上のスクリプトを実行して少し待つと、指定したバケット内に、ジョブ名.jsonという名前の出力ファイルができます。
字幕ファイルの作成
字幕ファイルとして一般的なのはsrtという形式のようですが、上の操作をしても得られるのはjsonファイルです。そこで、jsonからsrtに変換する必要があります。 下のスクリプトによって、その変換が行なえます。
from datetime import date, datetime, time, timedelta
from boto3 import client
import json

s3_client = client("s3",region_name="us-east-1",aws_access_key_id="*****",aws_secret_
access_key="*****")
text = s3_client.get_object(Bucket="上のスクリプトで指定したバケット名",Key="上のスクリプトの出力ファイル")
response = json.loads(text["Body"].read().decode("utf-8"))
words = response["results"]["items"]

for i in range(len(words)):
        if not "start_time" in words[i]:
                words[i-1]["alternatives"][0]["content"]+= words[i]["alternatives"][0]["content"]


words = list(filter((lambda x:"start_time" in x), words))


def timestr(timeobj):
        return timeobj.strftime('%H:%M:%S,') + '%03d' % (timeobj.microsecond // 1000)

with open("srtファイルに付けたい名前","w") as f:
        for i,c in enumerate(words):
                startTime = float(c['start_time'])
                endTime = float(c["end_time"])
                st = datetime.combine(date.today(),time(0,0))+timedelta(seconds=startTime)
                et = datetime.combine(date.today(),time(0,0))+timedelta(seconds=endTime)
                f.write("%d\n%s --> %s\n%s\n\n" % (i+1,timestr(st),timestr(et),c["alternatives"][0][
"content"]))
このスクリプトだと1単語ずつの字幕になってしまっていますが、字幕が作れるという事が言いたいだけなのでご容赦ください。 1単語ごとではなくうまい具合に区切った字幕を出したい場合、完全に手入力でないなら、自然言語処理のパッケージを使う必要があると思います。
srtファイルの合成
これでsrtファイルが手に入りました。 pythonのみでsrtファイルを動画に合成する方法が見つからなかったので、今回はフリーソフトを使いました。字幕を合成できるやつであればなんでもいいですが、今回はmacXvideoを使いました。本筋から外れるので、詳細は省きます。
合成に成功すると、動画に下の画像のような字幕が付きます。
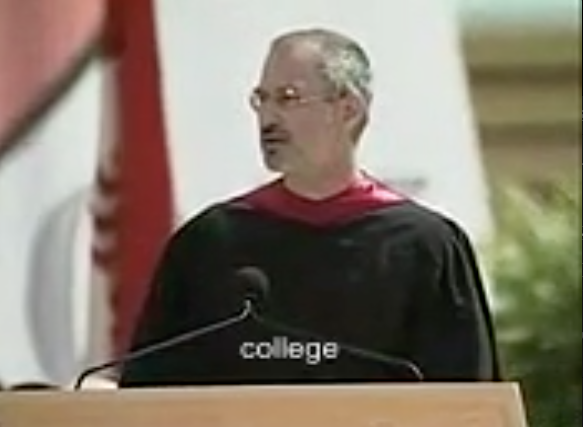
解析の結果をそのまま使っていますので、単語を発しているときだけ字幕が表示されています。
まとめ
Amazon Transcribeを使えば、人間が聞いて作成するよりも圧倒的に早く動画へ字幕をつけられます。
今回は単語の時間を表示したため、違和感のある動画が出来上がってしまいましたが、
実際には文単位で処理するのが普通です。
単語の認識はしっかりと行えているので、その調整をしっかりと行えればすでに使用できるレベルかと思います。


